KI & APIs
DeepSeek DeepInfer verstehen und nutzen
DeepSeek DeepInfer erklärt: unterstützte Hardware, Installation aus dem Quellcode, Offline-Inferenz, JSON-Ausgaben, Benchmarks und Grenzen im Produktivbetrieb.
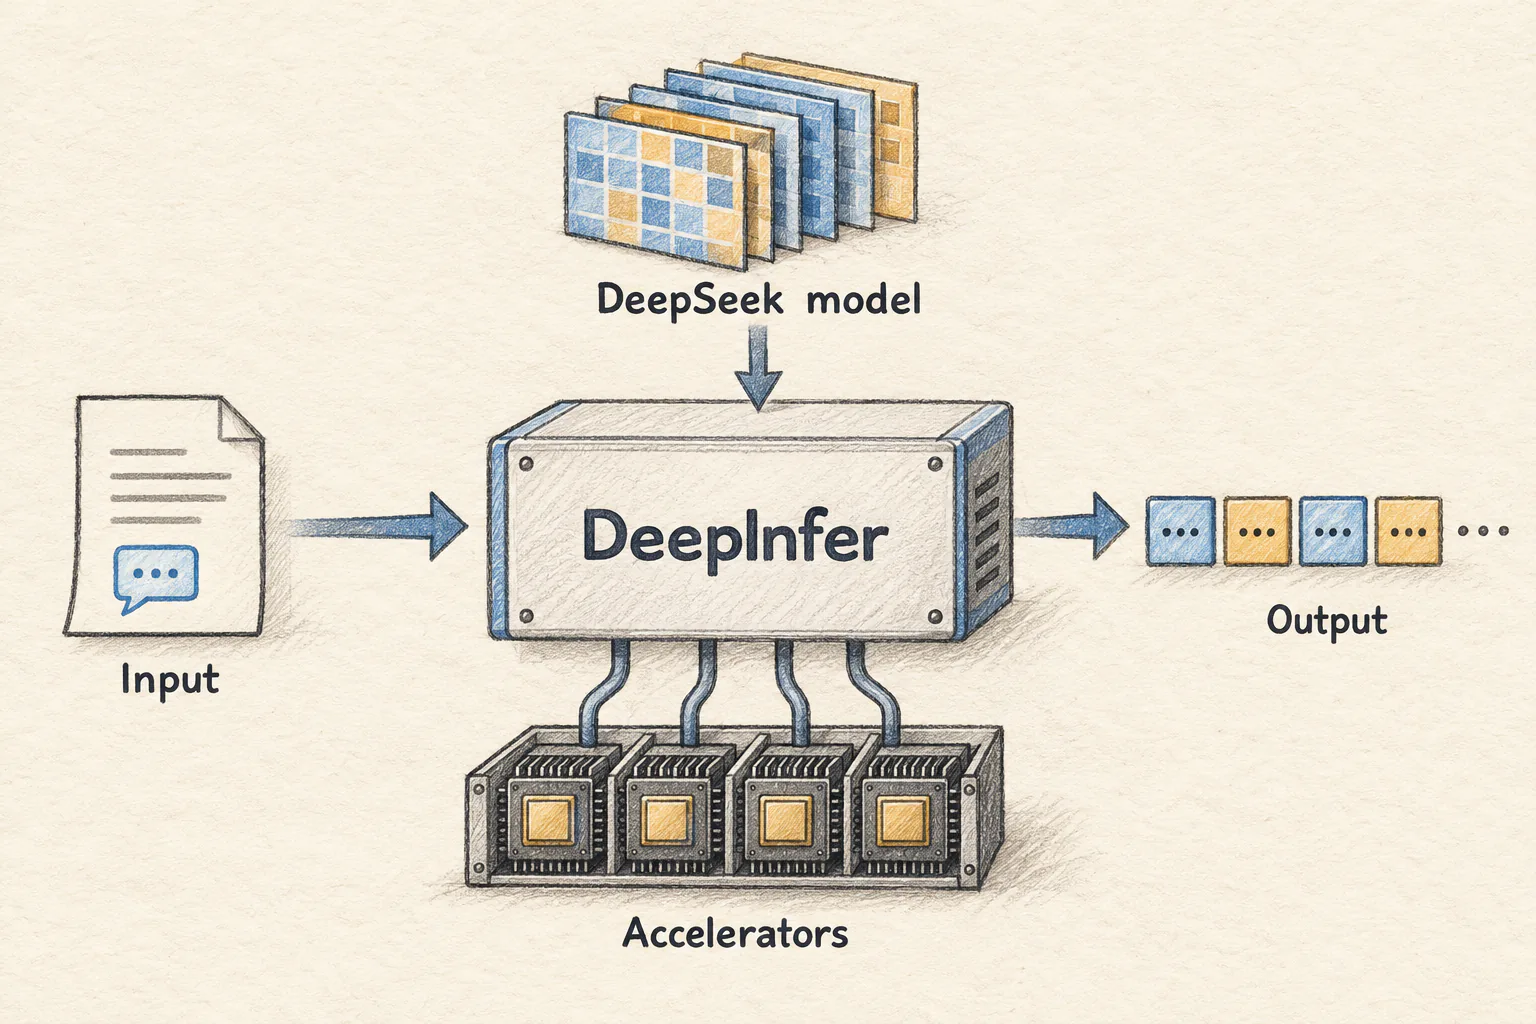
DeepInfer ist das quelloffene Inferenzframework von DeepSeek. Es führt ein trainiertes Modell auf Beschleunigern aus und erzeugt aus Eingaben neue Tokens. DeepSeek beschreibt es als Grundlage seiner großen Produktivdienste; die öffentliche Version stellt Offline-Inferenz und wesentliche Funktionen der Engine bereit.
Wer die Gewichte eines DeepSeek-Modells herunterlädt, hat zunächst dessen gelernte Parameter. Für die effiziente Berechnung, die Zusammenarbeit mehrerer Geräte und die Auswahl der nächsten Tokens wird zusätzliche Software benötigt. Diese Ausführung übernimmt DeepInfer.
Dieser Leitfaden erklärt, was DeepSeek DeepInfer leistet, welche Hardware unterstützt wird und wie du den Quellcode baust und die offiziellen Beispiele ausführst. Danach folgen ein kleines Beispiel für strukturierte Ausgaben und die Komponenten, die für einen vollständigen Onlinedienst noch erforderlich sind.
Quellenstand: 23. Oktober 2026. Der Artikel bezieht sich auf DeepInfer-Commit 9bd9cf2. Befehle und Python-Beispiele wurden mit diesem Quellstand abgeglichen, die Python-Syntax wurde geprüft. Auf dem Rechner für diesen Artikel wurden weder Inferenz auf Beschleunigern noch DeepSeeks Benchmarks ausgeführt.
1. Was ist DeepSeek DeepInfer?
Stell dir ein Orchester mit einer ausführlichen Partitur vor. Die Noten enthalten die musikalischen Informationen. Trotzdem muss jemand koordinieren, welches Instrument wann spielt und wie die einzelnen Stimmen zusammenpassen.
Bei einem Sprachmodell entsprechen die Gewichte ungefähr der Partitur. Die Inferenzengine koordiniert die Berechnung. DeepSeek entwickelt die Modelle; DeepInfer gehört zur Software, die diese Modelle ausführt.
Die Namen bezeichnen verschiedene Ebenen:
| Name | Bedeutung in diesem Artikel |
|---|---|
| DeepSeek | Die Organisation hinter Modell und Framework |
| DeepSeek-V4.1-Flash | Die in dieser DeepInfer-Version ausdrücklich unterstützte Modellfamilie |
| DeepSeek-V4.1-Flash-1017 | Der von den Beispielen standardmäßig verwendete Checkpoint |
| DeepInfer | Die Inferenzengine und der zugehörige Laufzeitcode |
| Onlinedienst | Ein größeres System mit Anfrageannahme, Routing und Betriebsfunktionen |
DeepInfer ist interessant, wenn du diese Ausführungsschicht untersuchen oder betreiben möchtest. Für eine Anwendung, die lediglich einen vorhandenen gehosteten Endpunkt aufruft, ist es nicht nötig, eine Inferenzengine zu kompilieren.
DeepSeek veröffentlicht DeepInfer unter Apache 2.0. Die Lizenz des Frameworks und die Bedingungen des eingesetzten Modell-Checkpoints sind getrennt zu prüfen. Die offizielle DeepInfer-README beschreibt Modelle, Hardware und Umfang der Veröffentlichung.
2. Warum DeepSeek eine Inferenzengine braucht
Ein Dienst erhält ein langes Dokument und soll eine kurze Antwort schreiben. Dabei fallen zwei Arten von Arbeit an.
Zuerst verarbeitet das Modell die Eingabe. Diese Phase heißt Prefill. Anschließend erzeugt es die Fortsetzung in wiederholten Decodierschritten. Das ist die Decode-Phase.
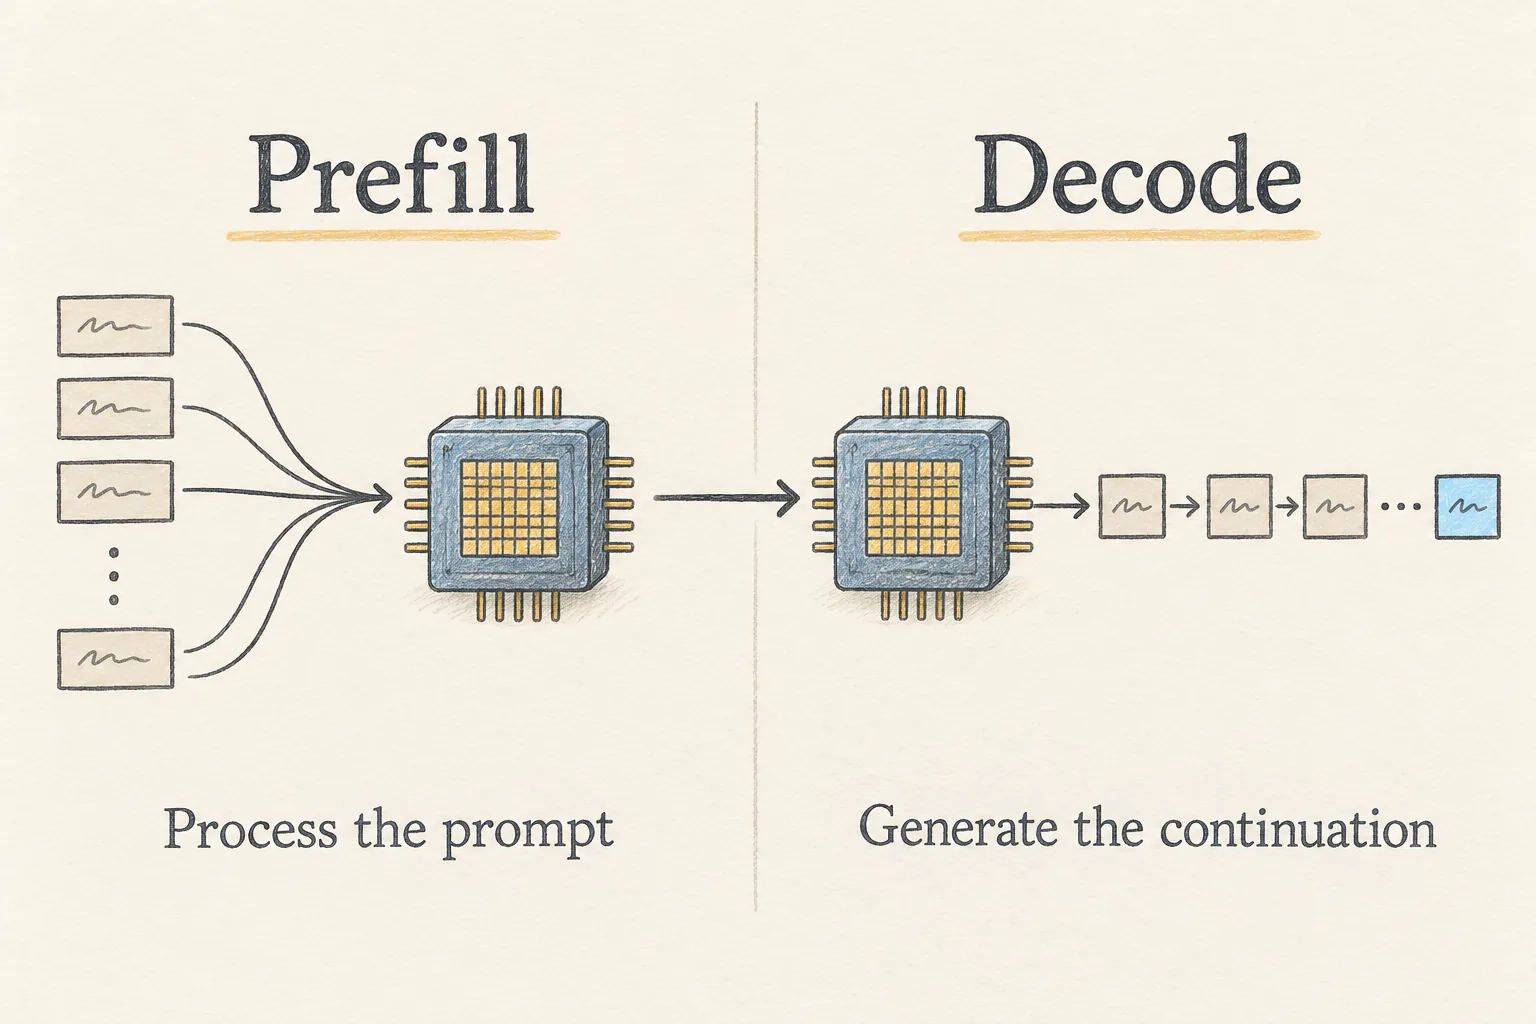
Bei vielen gleichzeitigen Anfragen muss das System diese Arbeit zwischen Anfragen und Geräten koordinieren. Eine schnelle Einzelberechnung reicht dafür nicht aus: Beschleuniger können auch auf die Planung des nächsten Schritts oder auf Kommunikation warten.
DeepInfer verbindet optimierte Rechenkerne, parallele Ausführung, asynchrone Planung und Decodierverfahren, die zunächst Tokens vorschlagen und anschließend überprüfen. DeepSeek stellt außerdem Einstellungen für reproduzierbare Ergebnisse und vorgegebene Ausgabeformate bereit.
Beim Lesen der Konfiguration helfen drei Begriffe:
- Datenparallelität (DP): verteilt Anfragen auf Replikate der Attention-Seite.
- Kontextparallelität (CP): verteilt die Attention-Berechnung eines Kontexts auf mehrere Geräte.
- Expertenparallelität (EP): verteilt die Expertenberechnung eines Mixture-of-Experts-Modells. Der Expertenlastausgleich (EPLB) hilft, diese Arbeit gleichmäßiger zu verteilen.
DeepSeek DeepInfer kombiniert diese Verfahren. Deshalb beschreiben --ep, --dp und --cp zusammenhängende Teile einer Topologie. Prüfe bei Änderungen immer auch die Gerätekapazität und die Bedingungen des Launchers.
3. Zuerst die DeepInfer-Kompatibilität prüfen
Für den hier untersuchten Stand nennt DeepSeek folgende Plattformen und Voraussetzungen:
| Voraussetzung | Dokumentierter Wert |
|---|---|
| Betriebssystem | Linux |
| Python | 3.12 |
| Compiler | GCC ab 13.0 |
| NVIDIA-Geräte | SM100-GPUs |
| NVIDIA-Toolkit | CUDA 13 |
| Huawei-Geräte | Ascend-950-NPUs |
| Huawei-Toolkit | CANN 9.2 |
| Modellfamilie | DeepSeek-V4.1-Flash |
Eine CUDA-Installation allein belegt nicht, dass deine GPU unterstützt wird. Auch ein von DeepSeek veröffentlichtes Modell ist nicht automatisch mit dieser DeepInfer-Version kompatibel. Prüfe die tatsächliche Architektur des Beschleunigers und den Checkpoint, bevor du Hardware bereitstellst.
Das offizielle Offline-Beispiel verwendet standardmäßig --ep 8. Das beschreibt eine Beispieltopologie und garantiert keine bestimmte Mindestgröße des Gerätespeichers. Wie viele Geräte nötig sind, hängt zusätzlich von Modell, Speicherkapazität, Kontextlänge, Batch-Einstellungen und Verbindung zwischen den Geräten ab.
Auf einem NVIDIA-System geben diese Befehle einen ersten Überblick:
python3.12 --version
gcc --version
nvcc --version
nvidia-smi
Die Befehle zeigen Python, Compiler, CUDA-Compiler und erkannte GPUs an. Vergleiche die tatsächlichen Ergebnisse anschließend mit den Voraussetzungen von DeepSeek.
4. DeepSeek DeepInfer aus dem Quellcode bauen
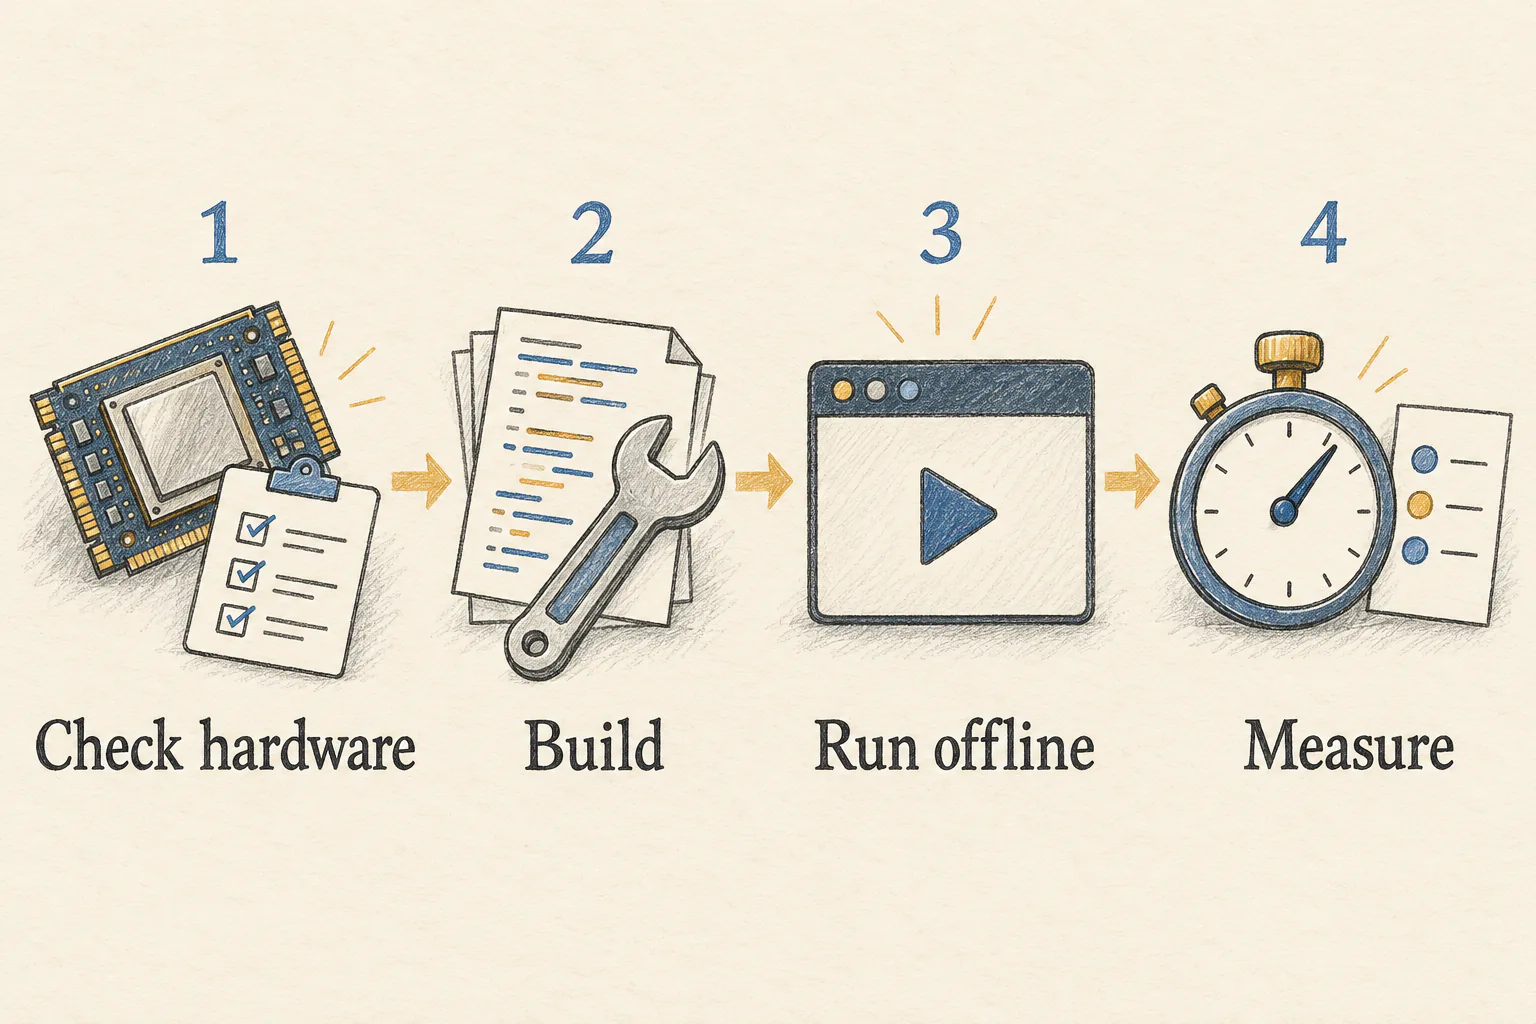
Verwende eine eigene Umgebung auf einem unterstützten Linux-System. Die sinnvolle Reihenfolge lautet: Plattform prüfen, DeepInfer bauen, Offline-Ausgaben validieren und anschließend die Leistung messen.
Lade zunächst den Quellcode. Der folgende Checkout wählt den in diesem Artikel geprüften Commit, damit spätere Änderungen am Hauptzweig die Anleitung nicht unbemerkt verändern.
org=https://github.com/deepseek-ai
git clone "$org/DeepInfer.git"
cd DeepInfer
git checkout 9bd9cf2
python3.12 -m venv .venv
source .venv/bin/activate
Damit legst du im Projekt eine isolierte Python-3.12-Umgebung an und aktivierst sie. Lass diese Umgebung beim Bauen und Ausführen von DeepInfer aktiviert.
Auf einem unterstützten NVIDIA-System wählst du den Beschleunigertyp und startest das Build-Skript:
export \
  DEEPINFER_ACCELERATOR=nvidia
./build.sh
Hier wählt DEEPINFER_ACCELERATOR den NVIDIA-Pfad. Die Variable muss auch beim Ausführen von DeepInfer gesetzt bleiben. Auf einem unterstützten Ascend-System mit CANN 9.2 verwendest du stattdessen ascend und richtest die Umgebung dieser Plattform ein.
Das Build-Skript installiert die Plattformabhängigkeiten, baut eingebundene Operatoren und anschließend DeepInfer. Das Skript für externe Operatoren initialisiert die benötigten Git-Submodule. Plane für diesen nativen Build Kompilierzeit und Netzwerkzugriff ein.
5. DeepSeek offline ausführen
Nach einem erfolgreichen Build startest du das mitgelieferte Beispiel im Hauptverzeichnis des Repositorys:
python \
  examples/offline_inference.py \
  --ep 8
--ep 8 setzt hier ausdrücklich die voreingestellte Größe der Expertenparallelität. Die übrige Topologie muss zu deiner tatsächlichen Gerätezuweisung passen. Das Skript verarbeitet vorgegebene Beispiele und gibt Ergebnisse sowie Diagnosefelder aus. Es startet keinen HTTP-Server.
DeepInfer verwendet standardmäßig die Modellkennung deepseek-ai/DeepSeek-V4.1-Flash-1017. Falls der Checkpoint noch nicht vorhanden ist, lädt die Hilfsfunktion ihn beim ersten Lauf in den Hugging-Face-Cache. Prüfe vorher, wie viel Speicherplatz die Modelldateien benötigen.
Liegt der vollständige DeepSeek-Checkpoint bereits lokal vor, kannst du sein Verzeichnis angeben:
export DEEPINFER_HF_MODEL_DIR=\
/models/DeepSeek-V4.1-Flash-1017
python \
  examples/offline_inference.py \
  --ep 8
Ersetze /models/DeepSeek-V4.1-Flash-1017 durch deinen tatsächlichen Pfad. Das Verzeichnis muss Modellkonfiguration und Gewichte enthalten. Die Variable leitet das Standardmodell auf die lokale Kopie um; einen ausdrücklich angegebenen Wert für --model_name überschreibt sie nicht.
Achte auf generierten Text, die Anzahl der Ausgabetokens, Angaben zur Annahme vorgeschlagener Tokens und die Diagnose decode_ppl. Ein abgeschlossener Lauf zeigt, dass Modell und Engine auf dieser Konfiguration zusammenarbeiten. Er belegt noch keine Genauigkeit deiner Anwendung oder Kapazität eines Produktivdienstes. Das Verhalten steht im Offline-Beispiel von DeepInfer und in der Ladefunktion für Modelle.
6. DeepInfer einen eigenen Prompt geben
Das offizielle Beispiel erstellt seine Testprompts in examples/_prompts.py. Sobald es unverändert funktioniert, kannst du innerhalb von main() die bereits initialisierte Instanz llm und die verteilte Konfiguration wiederverwenden.
Füge diesen Block in examples/offline_inference.py vor llm.close() ein. Passe seine Einrückung an den umgebenden Funktionskörper an:
from deepinfer import (
    sampling_params as sp,
)

prompt = (
    "Complete this sentence: "
    "A useful software test should"
)
params = sp.SamplingParams(
    temperature=0, max_tokens=64,
)
outputs = llm.generate(
    prompts=[prompt],
    sampling_params=params,
    use_tqdm=False,
)
tokens = [t.token_id
          for t in outputs[0]]
text = llm.get_tokenizer().decode(
    tokens,
    skip_special_tokens=True,
)
print(text)
In diesem Block ist llm die bestehende Engine. max_tokens begrenzt die Fortsetzung, und die letzten Zeilen wandeln die Tokenobjekte in Text um. Der Block ergänzt das vorhandene Beispiel; er initialisiert die Engine nicht selbst. Bei mehreren datenparallelen Arbeitsprozessen führt jeder Prozess die Ergänzung aus.
Der Prompt verlangt bewusst eine einfache Textfortsetzung. Eine Chatanwendung sollte das Format des gewählten DeepSeek-Checkpoints verwenden. Ein messages-Dictionary aus einer gehosteten API ist nicht automatisch das Eingabeformat dieses Python-Aufrufs. Maßgeblich ist der LLM-Einstiegspunkt von DeepInfer.
7. Strukturierte Ausgaben mit DeepSeek DeepInfer
Eine Anwendung soll Supporttickets den Kategorien billing, bug oder other zuordnen. Ein erklärender Absatz ist für Menschen gut lesbar. Für den Anwendungscode ist ein fest aufgebautes JSON-Objekt häufig praktischer.
DeepInfer unterstützt eine eingeschränkte Generierung mit regulären Ausdrücken, JSON-Schemas und EBNF-Grammatiken. Führe zuerst die eingebauten Prüfungen aus:
python \
  examples/offline_inference.py \
  --ep 8 --check_structured_output
Die Option verwendet nach den normalen Beispielen das bereits geladene DeepSeek-Modell erneut. Sie prüft die Fälle mit strukturierten Ausgaben einschließlich eines regulären Abschlusses.
Für ein eigenes Beispiel ersetzt du den zusätzlichen Block aus dem vorherigen Abschnitt durch folgenden Code in derselben initialisierten Funktion main():
import json
from deepinfer import (
    sampling_params as sp,
)

schema = {
    "type": "object",
    "properties": {
        "route": {
            "type": "string",
            "enum": [
                "billing", "bug",
                "other",
            ],
        },
    },
    "required": ["route"],
    "additionalProperties": False,
}
schema_json = json.dumps(schema)
params = sp.SamplingParams(
    temperature=0, max_tokens=64,
    so_args={
        "schema_type": "json",
        "schema": schema_json,
    },
)
Hier beschreibt schema das erlaubte Objekt. params übergibt diese Vorgabe an den Sampler von DeepInfer. Ergänze anschließend in derselben Funktion ein kurzes Ticket und die Auswertung der Antwort:
prompt = (
    "Route this ticket: "
    "I was charged twice. "
    "Return JSON."
)
outputs = llm.generate(
    prompts=[prompt],
    sampling_params=[params],
    use_tqdm=False,
)
tokens = [t.token_id
          for t in outputs[0]]
text = llm.get_tokenizer().decode(
    tokens,
    skip_special_tokens=True,
)
print(json.loads(text))
Das Schema verlangt genau ein Feld route und begrenzt dessen mögliche Zeichenketten. json.dumps(schema) liefert das Schema in der Form, die auch DeepSeeks Beispiel für strukturierte Ausgaben verwendet.
Die beabsichtigte Kategorie ist billing; das ist kein Messergebnis dieses Artikels. Die Einschränkung kontrolliert Form und zulässige Werte. Du musst weiterhin prüfen, ob die Zuordnung stimmt, ob die Generierung abgeschlossen wurde und ob deine Anwendung mit fehlgeschlagenen oder abgeschnittenen Antworten umgehen kann.
8. DeepInfer messen und die Zahlen richtig lesen
Miss die Leistung erst, wenn DeepSeek DeepInfer auf deiner Hardware gültige Ausgaben erzeugt. Halte Quellstand, Checkpoint, Beschleunigertyp, Gerätezahl, Kontextlänge, Batch-Größe und Einstellungen für spekulatives Decodieren fest.
Das folgende Beispiel nimmt einen einzelnen Knoten mit acht unterstützten NVIDIA-Geräten an. Es legt die Geräteauswahl offen und schaltet den Profiler für die Messung aus:
export WORLD_SIZE=1 RANK=0
export CUDA_VISIBLE_DEVICES=\
0,1,2,3,4,5,6,7
PROFILE=0 \
  python examples/benchmark.py \
  --prompt_mode text \
  --decode_num_requests 8 \
  --result_jsonl results.jsonl
WORLD_SIZE bezeichnet im Beispiel-Launcher die Anzahl der Knoten. Die Liste sichtbarer Geräte fließt ebenfalls in die ermittelte Parallelisierung ein. Passe diese Liste an deine tatsächlich zugewiesenen Geräte an. Die Werte beschreiben keine allgemeingültige Mindestkonfiguration.
Der DeepInfer-Benchmark trennt die Einstellungen für Prefill und Decode. --prefill_batch_size steuert beispielsweise die Prefill-Blöcke, während --decode_num_requests die Decode-Batch-Größe bestimmt. Ein höherer Wert auf einer Seite erhöht nicht einfach den anderen.
Bei den von DeepSeek angegebenen Durchsatzwerten ist die Zählweise entscheidend. Die Beispieldokumentation berechnet den Decode-Durchsatz unter der Annahme, dass alle vorgeschlagenen Tokens akzeptiert werden, auch wenn die tatsächliche Annahmerate abweicht. Dieser Wert entspricht daher nicht automatisch der Anzahl tatsächlich akzeptierter und an Nutzer ausgegebener Tokens. Nenne bei Vergleichen die Annahmen und untersuche zusätzlich Latenz und tatsächliche Ausgaben.
Die zentralen DeepInfer-Diagramme verwenden vier SM100-GPUs für Prefill und 64 für Decode, jeweils innerhalb einer Scale-up-Domäne. Die Ergebnisse gelten für diese Konfigurationen und sagen nicht direkt voraus, was der obige Lauf mit acht Geräten erreicht. Details liefern die Benchmark-Methodik und der offizielle Leistungsabschnitt.
9. Drei wichtige DeepInfer-Einstellungen
Beginne mit einem funktionierenden Beispiel. Ändere jeweils nur eine Einstellung und vergleiche sowohl die Ergebnisse als auch das Laufzeitverhalten.
Für den untersuchten DeepInfer-Stand sind diese Optionen hilfreich:
DEEPINFER_USE_NEXTN_DECODEsteuert die maximale Länge des Tokenentwurfs. Der dokumentierte Standard ist 5; 0 deaktiviert in den Beispielen das spekulative Decodieren.DEEPINFER_ENABLE_MTP_VARLEN=1aktiviert den dokumentierten DSpark-Pfad mit einer anhand von Konfidenzwerten geplanten Verifikation.DEEPINFER_BATCH_INVARIANT=1aktiviert auf dem unterstützten NVIDIA-Pfad eine Inferenz, deren Ergebnisse von der Zusammensetzung des Batches unabhängig bleiben.
DeepSeeks Rezept für deterministisches Sampling verlangt zusätzlich zur Batch-Invarianz DEEPINFER_ENABLE_MTP_VARLEN=0 und einen festen seq_seed in SamplingParams. Ein fester Seed allein ist somit nicht die vollständige dokumentierte Konfiguration. Siehe die DeepInfer-Funktionseinstellungen für Optionen und Plattformgrenzen.
10. Was ein produktiver DeepSeek-Dienst noch braucht
Die öffentliche DeepInfer-Version liefert die Engine als Grundlage. DeepSeek nennt ausdrücklich drei Bestandteile, die für einen vollständigen Inferenzdienst nötig sind und in dieser Veröffentlichung nicht als komplette Dienstimplementierung enthalten sind:
- Ein KV-Cache-System, das wiederverwendbare Attention-Zustände auf Dienstebene verwaltet.
- Die Trennung von Bildkodierung, Prefill und Decode in Dienststufen. Ein großer Teil der erforderlichen Engine-Funktionen ist bereits implementiert.
- Die Lastverteilung zwischen datenparallelen Replikaten für Prefill und Decode.
Das bedeutet nicht, dass die Engine intern ohne Attention-Zustand arbeitet. Die README unterscheidet zwischen Engine-Funktionen und der vollständigen Infrastruktur um sie herum.
Für deine eigene Bereitstellung kommen außerdem die Annahme und Begrenzung von Anfragen, Authentifizierung, Monitoring, Fehlerbehandlung und Kapazitätsplanung hinzu. Diese Aufgaben gehören zur Anwendung und zu ihrem Betrieb. Dieser Leitfaden liefert keinen fertig integrierten Onlinedienst.
Auch die Beziehung zu anderen Projekten sollte klar bleiben. Laut DeepSeek entstand DeepInfer ursprünglich vor allem auf Basis von vLLM; weitere Anregungen kamen von SGLang und TensorRT-LLM. Daraus folgt keine automatische Austauschbarkeit von Kommandozeilen oder Servern. Verwende die im DeepInfer-Repository beschriebenen Befehle und Schnittstellen.
11. Häufige Fragen zu DeepSeek DeepInfer
Ist DeepInfer ein neues DeepSeek-Modell?
Nein. DeepInfer ist Inferenzsoftware. Der hier geprüfte Stand unterstützt ausdrücklich die Modellfamilie DeepSeek-V4.1-Flash; ihre Gewichte werden separat geladen.
Läuft DeepInfer auf einem Laptop oder jeder CUDA-GPU?
Dokumentiert sind Linux sowie NVIDIA-SM100- oder Huawei-Ascend-950-Beschleuniger. Die README beschreibt für diese Veröffentlichung keinen reinen CPU-Betrieb, keinen macOS-Pfad und keine allgemeine Unterstützung für Consumer-GPUs.
Unterstützt DeepInfer jeden DeepSeek-Checkpoint?
Davon solltest du nicht ausgehen. Prüfe Modellliste und Loader, bevor du einen anderen Checkpoint auswählst. Derselbe Herausgeber garantiert keine kompatible Modellarchitektur.
Startet das Offline-Beispiel einen OpenAI-kompatiblen Server?
Nein. Es führt Offline-Beispiele aus. Ein HTTP-Dienst benötigt zusätzliche Integration und die zuvor beschriebenen Dienstkomponenten.
Liefert DeepInfer immer die richtige Antwort?
Nein. Schnelle Ausführung und gültiges JSON sind etwas anderes als eine sachlich richtige Antwort. Prüfe die Ausgaben des DeepSeek-Modells mit repräsentativen Aufgaben, schwierigen Eingaben und Fehlerfällen.
12. Ein sinnvoller Einstieg
DeepSeek DeepInfer macht die Ausführungsschicht eines Modells nachvollziehbar: Wie wird ein DeepSeek-Modell geladen, wie wird Rechenarbeit verteilt und wie entstehen neue Tokens? Besonders relevant ist das für Entwickler, die Inferenz auf den unterstützten Beschleunigern untersuchen oder betreiben.
Beginne mit passender Hardware und dem unveränderten Offline-Beispiel. Ergänze danach einen kleinen eigenen Prompt, prüfe bei Bedarf strukturierte Ausgaben und miss deine tatsächliche Arbeitslast. So erhältst du eine Grundlage für die Entscheidung, ob DeepInfer zu deiner DeepSeek-Bereitstellung passt.
Die wichtigsten Quellen sind das DeepInfer-Repository, der Beispielleitfaden und die Apache-2.0-Lizenz. Die Abbildungen sind eigens erzeugte KI-Konzeptzeichnungen, keine Produkt-Screenshots oder Benchmark-Messungen.