KI & APIs
Muse Wonder und Opus 5.5 im Vergleich
Eingaben, Preise und öffentliche Benchmarks vergleichen und Muse Wonder sowie Opus 5.5 anhand einer festen Aufgabe, gemeinsamer Kriterien und Gesamtkosten prüfen.
Muse Wonder und Claude Opus 5.5 sind Reasoning-Modelle für komplexe Aufgaben. Wonder stammt von Meta, Opus von Anthropic. Beide können Material analysieren, bei der Programmierung helfen und als Modell in einer Agentenanwendung dienen.
Die Wahl fällt schwer, weil Preislisten, Ranglisten und die eigene Arbeit unterschiedliche Fragen beantworten. Eine Preisliste nennt den Preis pro Token. Ein Benchmark misst die Leistung bei bestimmten Aufgaben. Für ein Produkt zählen außerdem Eingabeformate, Wartezeit und der Aufwand für menschliche Nacharbeit.
Dieser Vergleich folgt einem einzelnen Störungsticket: Zuerst prüfen wir, ob das Material beim Modell ankommen kann. Danach betrachten wir öffentliche Ergebnisse und Kosten. Schließlich entwerfen wir einen kleinen, wiederholbaren Vergleich. Quellen und Preise wurden am 13. Oktober 2026 geprüft.
Der Artikel wertet öffentliche Belege aus und schlägt eine Evaluationsmethode vor. Die Ergebnisse sind ihren Quellen zugeordnet. Die Aufnahmen der Oberfläche zeigen die Vorbereitung; sie dokumentieren keinen abgeschlossenen Modellvergleich durch uns.
1. Mit einem Störungsticket beginnen
Angenommen, einige Android-Nutzer landen nach einer Veröffentlichung wieder auf der Login-Seite. Vorhanden sind der Bereitstellungszeitpunkt, Fehlerprotokolle, Bildschirmfotos und eine kurze Aufnahme der Nutzeraktionen. Gesucht werden bekannte Fakten, zu prüfende Hypothesen und ein brauchbarer Untersuchungsplan.
Darin stecken mindestens zwei Fragen. Kann das Modell das Material verstehen? Und sind seine Empfehlungen anschließend durch die vorliegenden Informationen gedeckt?
Die Modellkarte von Muse Wonder nennt Text, Bilder, Video und Audio als Eingaben sowie Text als Ausgabe. Die öffentlichen Spezifikationen von Opus 5.5 nennen Text und Bilder als Eingaben. Beide bieten ein Kontextfenster von ungefähr einer Million Tokens. Modellkarte von Meta, Spezifikationen von Opus 5.5
Wer Video oder Audio direkt übermitteln möchte, sollte deshalb zunächst Wonder prüfen. Meta weist zugleich darauf hin, dass die Audioverfügbarkeit für den jeweiligen Zugang bestätigt werden muss. Bei einem Opus-Ablauf werden für dieses Material üblicherweise eine Transkription oder extrahierte Einzelbilder benötigt. Auch deren Kosten und mögliche Informationsverluste gehören in den Vergleich. Ankündigung für Entwickler von Meta
Ein großes Kontextfenster bietet Platz für mehr Informationen. Es garantiert nicht, dass das Modell jedes relevante Detail findet. Bei der Untersuchung sollten Fakten aus dem Material deshalb von Vermutungen getrennt werden, die eine weitere Prüfung erfordern.
2. Die verglichene Version festhalten
Hier vergleichen wir das regulär per API verfügbare Muse Wonder mit Claude Opus 5.5.
Meta hat zusätzlich Muse Wonder Full veröffentlicht. Diese Variante ist derzeit über bestimmte Muse-Code-Abonnements verfügbar. Das reguläre Modell besitzt außerdem unterschiedliche Kennungen bei Meta und OpenRouter. Offizielle Ankündigung zu den Zugängen
| Dienst | Modellname oder Kennung | Bedeutung für diesen Vergleich |
|---|---|---|
| Meta Model API | muse-wonder-1.0 |
Offizielle API für das reguläre Wonder |
| OpenRouter | meta/muse-wonder |
Kennung des regulären Wonder beim Vermittlungsdienst |
| Bestimmte Muse-Code-Abonnements | Muse Wonder Full | Eigenständige Variante; ihre Ergebnisse ersetzen nicht die des regulären Wonder |
| Claude API | claude-opus-5-5 |
Offizielle API für Opus 5.5 |
Kennungen und Zugänge sind bei Meta, OpenRouter und Anthropic dokumentiert.
Klären Sie auch, ob Sie eine Chatoberfläche, eine direkte API oder einen Agenten mit Werkzeugen verwenden. Die Fähigkeit eines Modells, einen Werkzeugaufruf anzufordern, bedeutet noch nicht, dass ein Chat-Endpunkt Befehle ausführt, ein Repository liest oder dauerhaft Informationen speichert.
3. Warum gleiche Tokenpreise zu verschiedenen Rechnungen führen
Beginnen wir mit den veröffentlichten Standardpreisen der APIs. Alle Werte gelten in US-Dollar pro Million Tokens.
| Kategorie | Muse Wonder | Opus 5.5 |
|---|---|---|
| Eingabe ohne Cache | 4,00 USD | 4,00 USD |
| Lesen aus dem Cache | 0,20 USD | 0,20 USD |
| Ausgabe | 20,00 USD | 20,00 USD |
Diese drei Preise stimmen überein. Preise von Meta, Preise von Anthropic
Bei ausschließlich 10.000 Eingabetokens ohne Cache und 2.000 abrechenbaren Ausgabetokens beträgt die grundlegende Tokengebühr für beide Modelle 0,08 USD. Das ist eine Rechnung mit festgelegtem Verbrauch. Ein tatsächlicher Durchlauf muss nicht denselben Verbrauch ergeben.
Längere Aufgaben übermitteln Kontext mehrfach, können den Cache nutzen und erfordern möglicherweise Wiederholungen. Reasoning, Werkzeugergebnisse und die abschließende Antwort beeinflussen die Rechnung. Auch die Tokenizer unterscheiden sich: Derselbe Text muss nicht dieselbe Tokenzahl ergeben.
Anthropic berechnet das Schreiben in den Cache separat: 5 USD pro Million Tokens für fünf Minuten und 8 USD für eine Stunde. Die asynchrone Batch API gewährt 50 Prozent Rabatt auf Eingabe und Ausgabe. Die oben verlinkte Meta-Ankündigung nennt keinen entsprechenden Batch-Rabatt. Legen Sie für einen Kostenvergleich den Betriebsmodus fest, damit Batch-Verarbeitung und interaktive Anfragen nicht vermischt werden. Abrechnungsdokumentation von Anthropic
Artificial Analysis meldet eine aufschlussreiche Kombination: Wonder erreicht bei maximalem Reasoning-Aufwand 52 Punkte im Intelligence Index und gewichtete Indexkosten von 4,52 USD pro Aufgabe. Opus 5.5 erreicht bei maximalem Aufwand mit standardmäßigem Fallback 58 Punkte und 5,98 USD pro Aufgabe. Wonder-Auswertung, Opus-Auswertung
Gleiche Tokenpreise, unterschiedliche Gesamtergebnisse und unterschiedliche Evaluationskosten können also gleichzeitig auftreten. Die Kosten pro Aufgabe sind hier eine nach Indexaufgaben gewichtete Kennzahl des Prüfers. Sie sind kein Preisangebot für die Bearbeitung Ihres Störungstickets.
4. „Fünf Siege aus vierzehn“ als Hinweis lesen
Zählt man die vierzehn Zeilen, in denen Metas veröffentlichte Ergebnistabelle das reguläre Wonder mit Opus 5.5 vergleicht, erhält Wonder fünfmal den höheren Wert und Opus neunmal. Diese Aussage lässt sich an der offiziellen Tabelle nachvollziehen. Ergebnistabelle von Meta
Vier Zeilen zeigen, wie unterschiedlich Programmieraufgaben sein können. Die Werte stammen aus Metas Tabelle; höhere Werte sind besser.
| Evaluation | Reguläres Wonder | Opus 5.5 |
|---|---|---|
| DeepSWE 1.1 | 78,8 | 74,2 |
| SWE-Marathon | 53,1 | 46,3 |
| Terminal-Bench 4.0-AA | 52,0 | 59,6 |
| ProgramBench | 50,0 | 70,5 |
Quelle: Veröffentlichte Ergebnisse von Meta. Die ersten beiden betreffen länger laufende Softwareentwicklung. Die letzten beiden betreffen Terminalaufgaben und die Rekonstruktion eines vollständigen Programms. Daraus ergibt sich keine einfache allgemeine Aussage darüber, welches Modell besser programmiert.
Die Fußnoten sind wichtig. Laut Modellkarte stammen die DeepSWE-Ergebnisse dieser Modelle von Datacurve. SWE-Marathon verwendet extern gemeldete Ergebnisse; die gesamte Zeile ist kein kontrollierter Vergleich mit einer gemeinsamen Agentenumgebung. Bei einigen intern erzeugten Ergebnissen anderer Anbieter beschreibt Meta die Konfiguration zudem als bestmögliche Annäherung. Evaluationsmethoden und Grenzen
Vierzehn Zeilen sind keine vierzehn unabhängigen Stimmen aus Ihrem Unternehmen. Zusammengesetzte Indizes überschneiden sich mit einzelnen Evaluationen. Selbst Wonders GDP.pdf-Wert von 30,8 gegenüber 30,6 enthält nicht die Angaben zur Unsicherheit, die für einen verlässlichen Vorsprung nötig wären. Die Zahlen helfen dabei, Aufgaben für die eigene Untersuchung auszuwählen.
Meine Empfehlung lautet: Opus 5.5 als Ausgangspunkt für allgemeine Programmierung und Wissensarbeit verwenden und Wonder bei längeren Entwicklungsaufgaben sowie nativen Audio- oder Videoeingaben mitprüfen. Das ist eine Einschätzung auf Grundlage öffentlicher Belege. Über den produktiven Einsatz sollten Ihre eigenen Abnahmeergebnisse entscheiden.
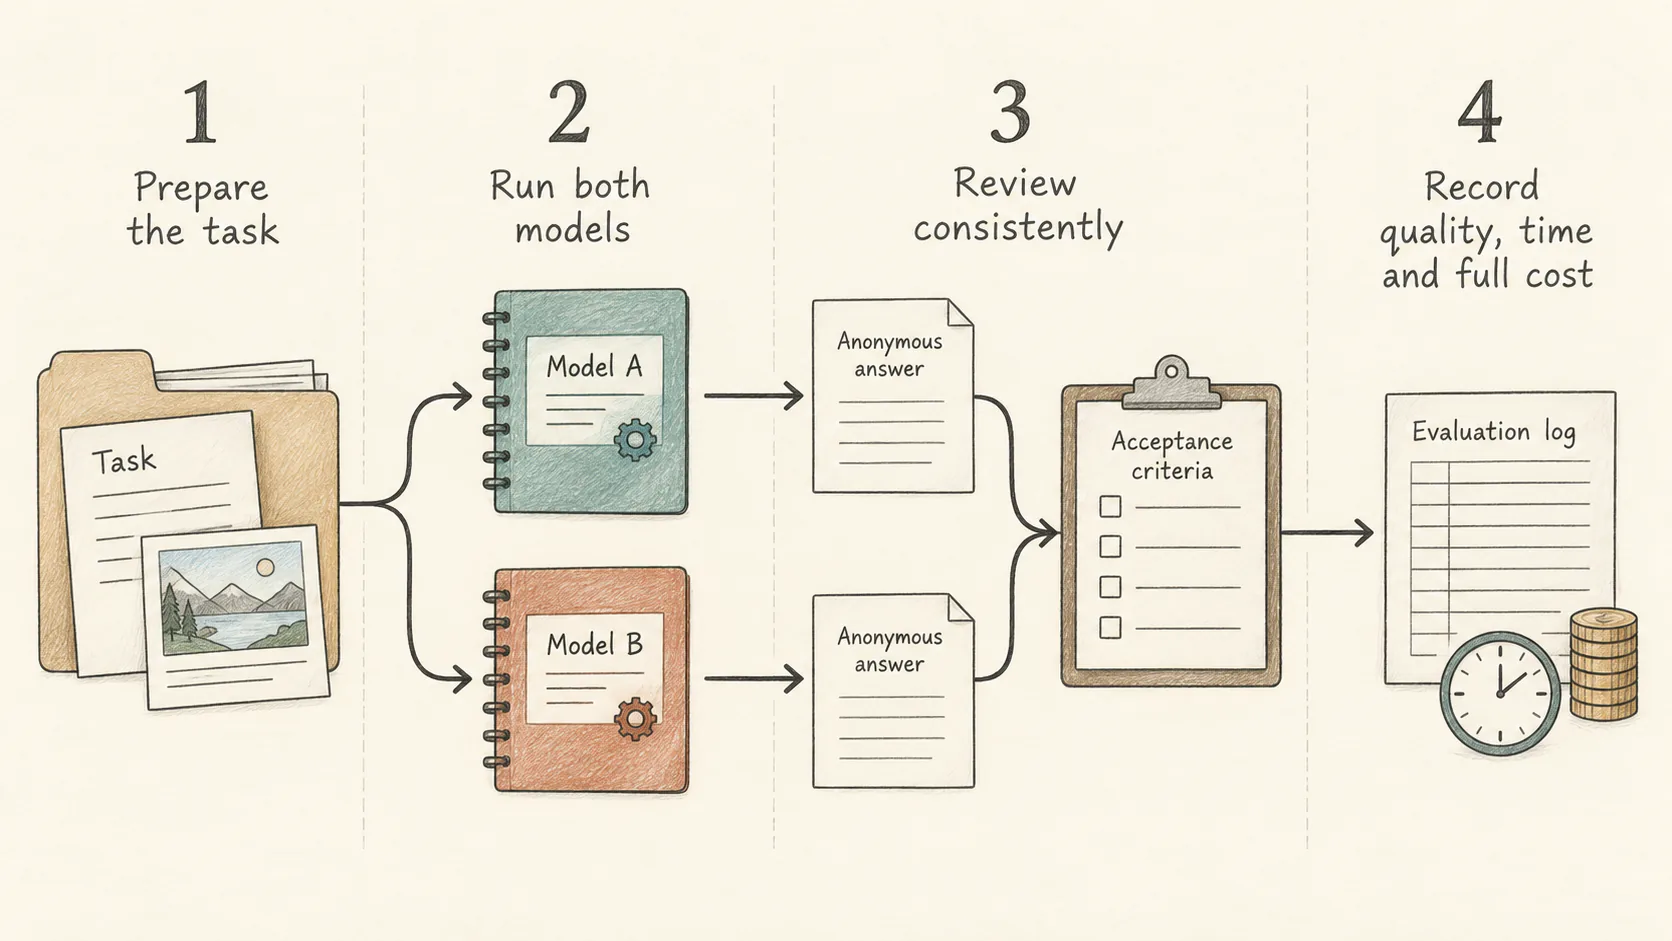
5. Einen Vergleich in vier Schritten wiederholbar machen
Kehren wir zum Login-Problem zurück. Vergleichen Sie zuerst Untersuchungspläne auf Basis des bereitgestellten Materials. Vergleichen Sie tatsächliche Reparaturen mit Repository-Zugriff und Werkzeugen separat. Diese Phasen brauchen unterschiedliche Berechtigungen, Kontextinformationen und Abnahmekriterien.
- Ein Materialpaket festlegen. Bei Text- und Bildaufgaben bekommen beide Modelle dieselben Belege. Bei Audio oder Video dokumentieren Sie den vollständigen Ablauf mit nativer Eingabe sowie den alternativen Ablauf mit Transkription oder Einzelbildern.
- Abnahmekriterien definieren. Trennt die Antwort Fakten von Hypothesen, nennt sie Belege und erhält sie wichtige Hinweise? Für Codeänderungen legen Sie Prüfungen und erlaubten Umfang vor dem Durchlauf fest.
- Konfiguration festhalten und Durchläufe wiederholen. Speichern Sie Modellversion, Reasoning-Einstellung, Werkzeuge, Prompt und Ausgabelimit. Eine Einstellung namens max bedeutet nicht bei beiden Modellen denselben Rechenaufwand. Vergleichen Sie zusätzlich ähnliche Zeit- oder Kostenbudgets.
- Antworten ohne sichtbaren Modellnamen bewerten und anschließend Gesamtkosten sowie menschliche Nacharbeit erfassen. Behalten Sie auch Fehlschläge und Wiederholungen bei, statt nur das beste Ergebnis auszuwählen.
Der folgende Prompt eignet sich als Ausgangspunkt für die Textanalyse.
Belege: Die Login-Seite wurde um 10:02 bereitgestellt; um 10:05 meldeten Android-Nutzer, nach der Anmeldung wieder zur Login-Seite zu gelangen; eine Reproduktion am Desktop ist noch nicht bestätigt.
Aufgabe: Trenne bekannte Fakten, zu prüfende Hypothesen und nächste Prüfungen.
Anforderung: Nenne für jede Schlussfolgerung die Belege; sage ausdrücklich, wenn Belege fehlen.
Grenze: Stelle Hypothesen nicht als Schlussfolgerungen dar und behaupte nicht, Prüfungen bereits ausgeführt zu haben.
Der Prompt legt die vorhandenen Fakten und den Schwerpunkt der Bewertung fest. Er prüft, ob das Modell bei Schlussfolgerungen vorsichtig bleibt. Eine Reparaturaufgabe benötigt zusätzlich Code, eine Laufzeitumgebung und ausführbare Abnahmebedingungen.
Eine weitere nützliche Kennzahl sind die Kosten pro abgenommener Aufgabe. Die folgenden zwei erfundenen Gesamtbeispiele erklären die Berechnung. Sie sind keine Messwerte dieser Modelle.
def cost_per_accepted(total_usd, accepted):
    return total_usd / accepted if accepted else float("inf")

print(cost_per_accepted(30, 60))  # 0,50 USD
print(cost_per_accepted(40, 90))  # etwa 0,44 USD
Die Gesamtkosten sollten hier Modellgebühren für Fehlschläge und Wiederholungen sowie tatsächlich anfallende Werkzeug- oder Vorverarbeitungskosten enthalten. Das zweite Beispiel gibt insgesamt mehr aus, kostet aber weniger pro abgenommener Aufgabe. Erfassen Sie menschliche Prüfzeit separat, damit dieser Aufwand sichtbar bleibt.
6. Zuerst die Wonder-Seite vorbereiten
Für die Wonder-Seite können Sie unseren multimodalen Playground von Decisions API verwenden. Preise und Grenzen stehen auf der eigenen Modellseite. Die vollständige Anleitung für Schlüssel und API finden Sie unter Einstieg in Muse Wonder.
- Melden Sie sich an, prüfen Sie Ihr Guthaben und fügen Sie die Textbelege aus dem vorherigen Abschnitt ein.
- Beginnen Sie bei dieser kurzen Textaufgabe mit einem maximalen Ausgabewert von 256. Erhöhen Sie die Grenze, falls die Antwort abgeschnitten wird, und dokumentieren Sie die Änderung.
- Bewahren Sie nach dem Absenden Antwort, Verbrauch und tatsächliche Gebühr auf. Führen Sie dieselbe Textaufgabe in Ihrem gewählten Claude-Dienst aus.
Die Aufnahme zeigt die echte Oberfläche mit vorbereitetem Fall vor dem Absenden.
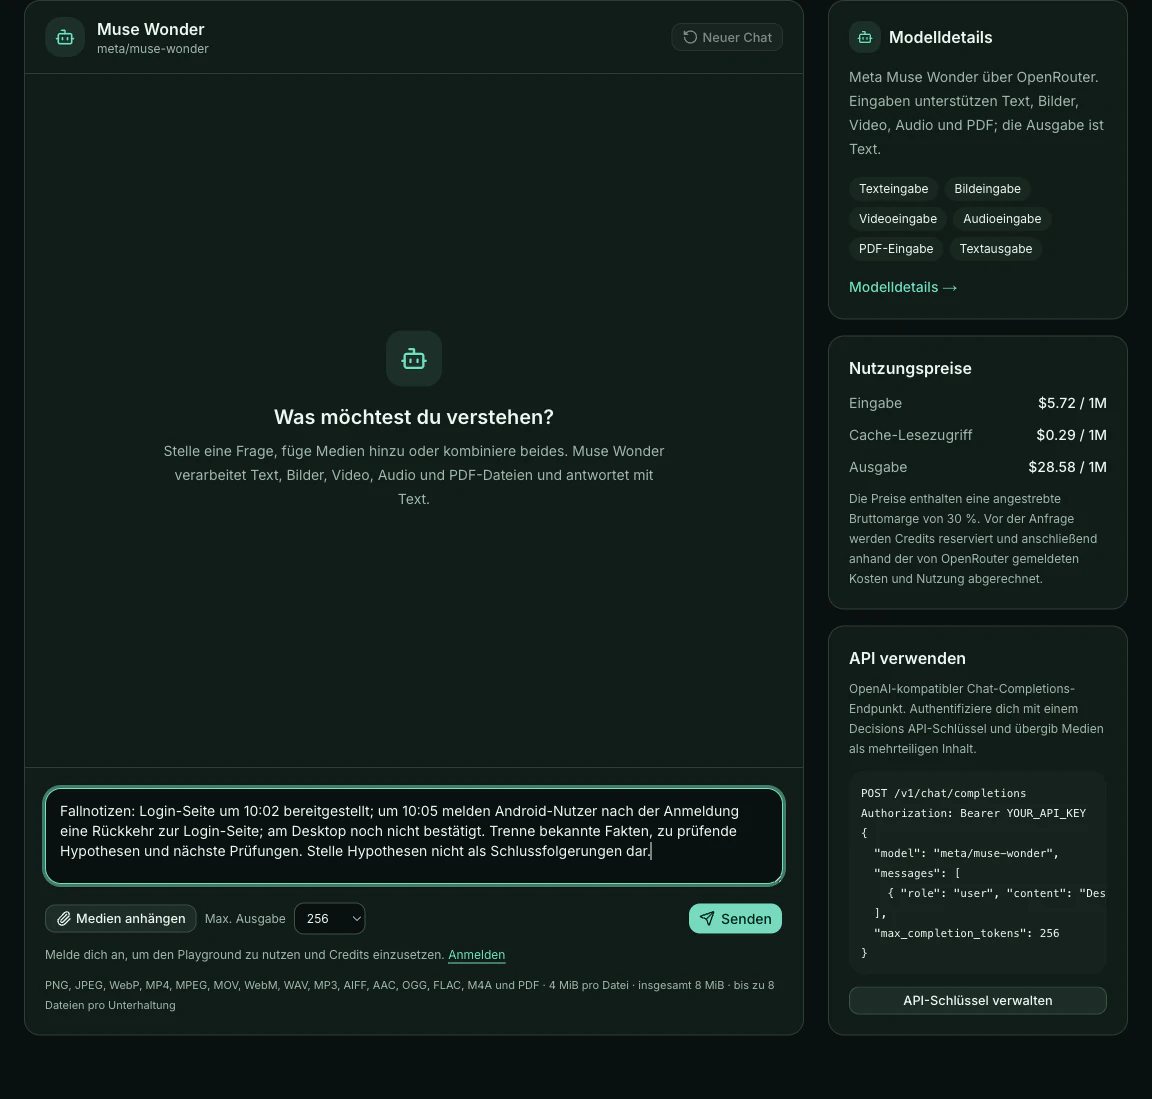
Dieser Chat-Endpunkt stellt derzeit meta/muse-wonder bereit. Opus 5.5 benötigt einen separaten Dienst. Die hier angezeigten Wonder-Preise betragen pro Million Tokens 5,72 USD für Eingaben, 0,29 USD für Cache-Lesezugriffe und 28,58 USD für Ausgaben. Das sind Plattformpreise; sie unterscheiden sich von den oben genannten Grundpreisen des Anbieters.
Der Playground unterstützt Text- und Medienchats. Der aktuelle Vermittlungsdienst aktiviert keine Werkzeugausführung und keinen einstellbaren Parameter für den Reasoning-Aufwand. Dieser Schritt prüft daher das Verständnis der Belege und die Antwortqualität. Für die Wiederholung eines Agentenbenchmarks mit maximalem Aufwand ist ein Endpunkt mit den entsprechenden Einstellungen und Werkzeugen nötig.
7. Nach der tatsächlichen Aufgabe entscheiden
Damit lässt sich eine praktische Entscheidungstabelle erstellen.
| Hauptaufgabe | Sinnvoller erster Vergleich |
|---|---|
| Allgemeine Programmierung und Wissensanalyse | Qualität und Kosten zunächst mit Opus 5.5 erfassen |
| Länger laufende Softwareentwicklung | Wonder im selben Repository mit denselben Abnahmekriterien mitprüfen |
| Natives Video- oder Audioverständnis | Wonders Unterstützung im jeweiligen Dienst bestätigen und den gesamten Opus-Ablauf mit Vorverarbeitung vergleichen |
| Nicht zeitkritische Hintergrundarbeit | Opus Batch als eigenen Betriebsmodus berechnen |
| Etablierter Produktionsablauf | Vor einem Modellwechsel oder einer Aufgabenverteilung eine kleine Stichprobe prüfen |
Die Modellwahl sollte eine nachvollziehbare Aufzeichnung hinterlassen: Was hat das Modell gelesen, was hat es richtig verstanden, wie lange hat es gebraucht und wie viel hat das abgenommene Ergebnis insgesamt gekostet? Ranglisten grenzen die Kandidaten ein. Diese Aufzeichnung hilft bei der Entscheidung für den produktiven Einsatz.
Weiterführende Artikel
Weitere Perspektiven bieten der Vergleich von MyClaw und Gabriel Anhaias Analyse der Ergebnistabelle von Meta. Preise und Ergebnisse in diesem Artikel wurden anhand der zuständigen offiziellen Quellen oder Evaluationsorganisation geprüft. Die beiden Artikel ergänzen diese Fakten um weitere Überlegungen zur Modellauswahl.