AI 与 API
DeepSeek DeepInfer 入门:是什么,怎么用
了解 DeepSeek DeepInfer 是什么、与 DeepSeek 模型有什么关系,以及支持的硬件、源码编译、离线推理、JSON 结构化输出、性能测试和生产部署边界。
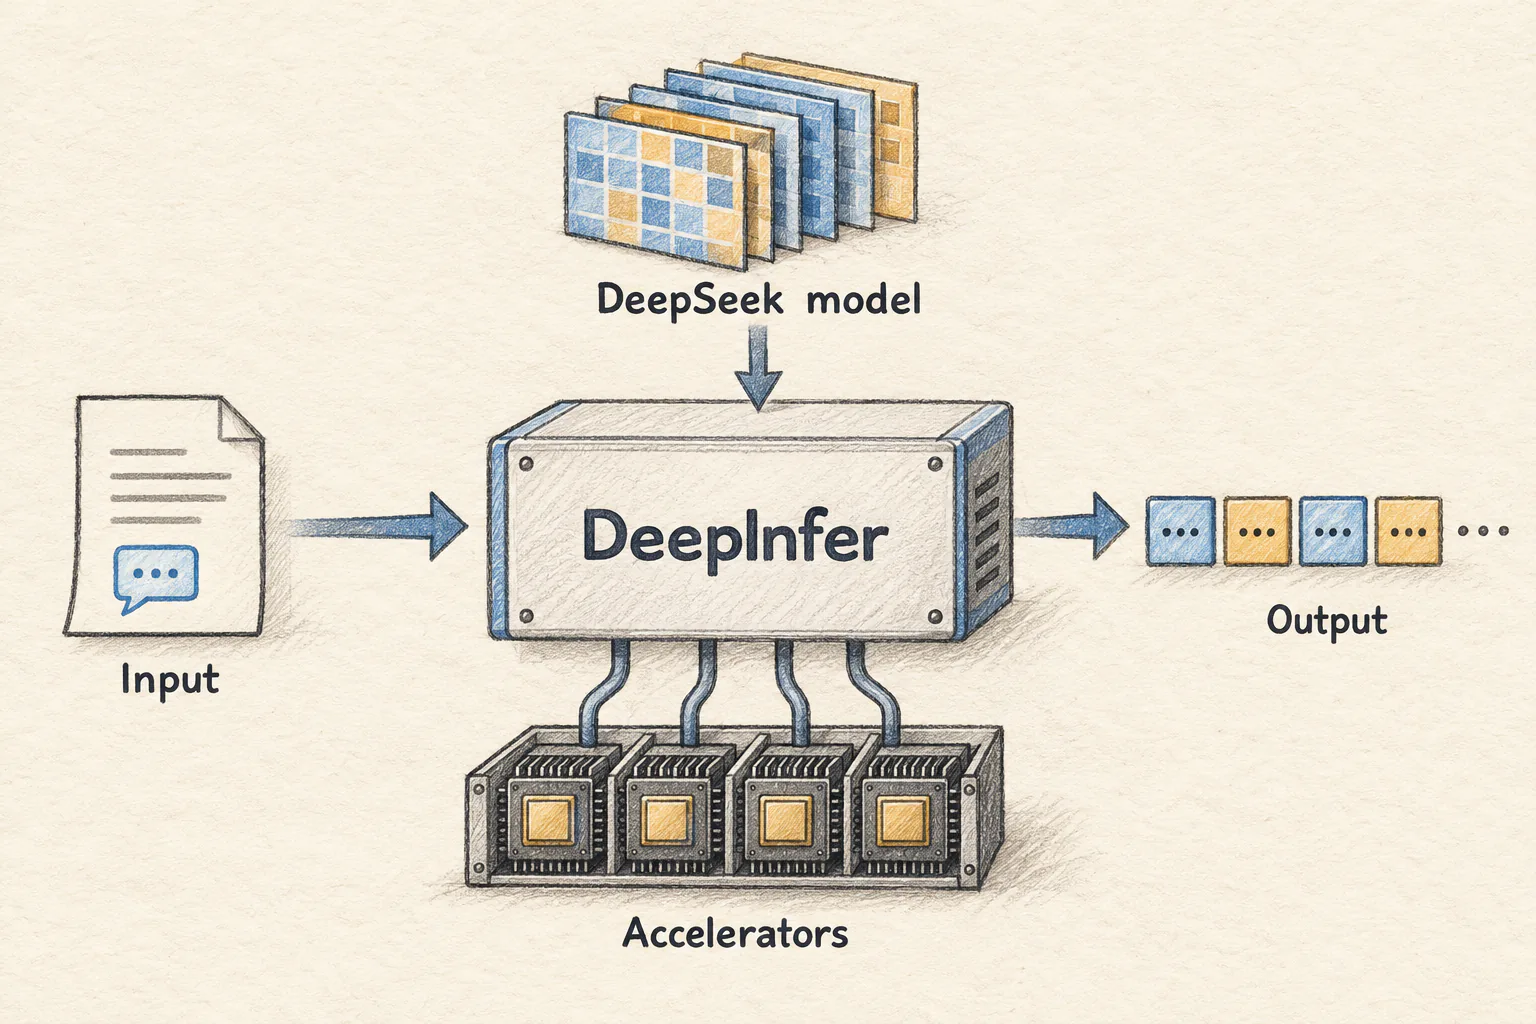
DeepInfer 是 DeepSeek 开源的推理框架:它负责在加速卡上运行训练好的模型,把输入转换成生成的词元。DeepSeek 将它介绍为支撑其大规模生产服务的推理框架;目前公开的版本提供离线推理和多项核心引擎能力。
下载 DeepSeek 模型权重,只是拿到了模型学到的参数。怎样执行这些参数、协调多张卡、选择下一个输出词元,还需要一层软件。DeepInfer 处理的就是这一层工作。
本文从基本概念讲起,介绍 DeepSeek DeepInfer 支持什么硬件、怎样编译、怎样运行官方示例,再用一个小例子说明结构化输出。最后,我们看看完整的在线服务还缺哪些组件。
资料核对日期:2026 年 10 月 23 日。 本文以 DeepInfer 提交 9bd9cf2 为准。命令与 Python 示例已按该版本源码核对,Python 片段已通过语法检查。撰写本文的机器没有执行加速卡推理,也没有复现 DeepSeek 的性能测试。
一、DeepSeek DeepInfer 到底是什么
可以想象一支乐队和一份详细的乐谱。乐谱记录了要演奏的内容,但哪些乐器何时加入、各部分怎样配合,还需要协调。
模型权重有点像乐谱,推理引擎负责协调计算。DeepSeek 开发模型,DeepInfer 则是执行这些模型的一部分软件。
下面几个名字,指的是不同层次的东西。
| 名称 | 本文中的含义 |
|---|---|
| DeepSeek | 发布模型与框架的组织 |
| DeepSeek-V4.1-Flash | 这个 DeepInfer 版本明确列出的模型系列 |
| DeepSeek-V4.1-Flash-1017 | 示例脚本默认加载的模型检查点 |
| DeepInfer | 推理引擎及相关运行时代码 |
| 在线推理服务 | 包含请求接入、路由和服务运维的更大系统 |
如果你需要研究或部署模型的执行层,DeepInfer 就值得了解。如果你的任务只是向已有的托管接口发送提示词,则不需要为此编译一套推理引擎。
DeepSeek 以 Apache 2.0 许可证发布 DeepInfer。框架的许可证与具体模型权重的使用条款需要分别确认。模型、硬件和开源范围,可以查阅 DeepInfer 官方说明。
二、为什么 DeepSeek 需要推理引擎
假设一个服务收到一篇长文档,需要生成一段简短回答。它要完成两类工作。
首先,模型处理输入,这个阶段称为预填充(Prefill)。然后,模型通过多次解码步骤生成后续内容,这个阶段称为解码(Decode)。
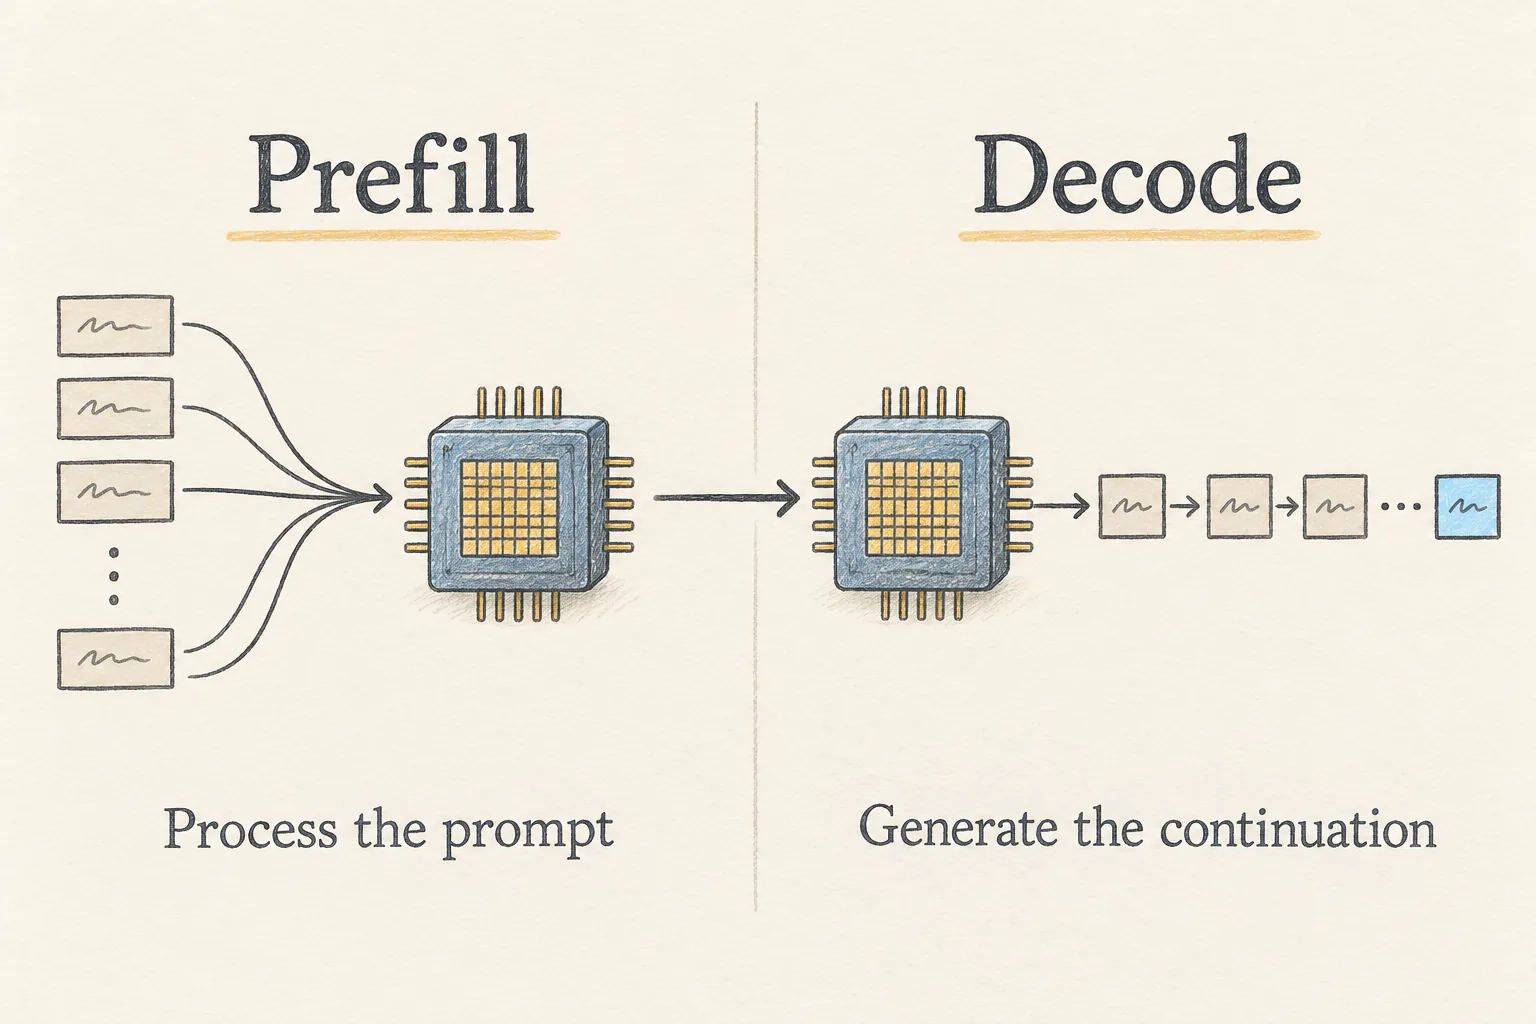
当许多请求同时到来,系统必须协调不同请求与不同设备。单个算子算得快,还不足以保证整体效率:设备也可能在等待调度或通信。
DeepInfer 同时处理这几个问题。它结合了优化后的计算内核、并行执行、异步调度,以及先提出草稿词元、再验证草稿的解码技术。DeepSeek 还提供了控制结果可重复性和输出格式的选项。
阅读配置时,可以先认识三个术语。
- 数据并行(DP):在注意力侧的多个副本之间分配请求工作。
- 上下文并行(CP):让多张设备分担一个上下文的注意力计算。
- 专家并行(EP):分散混合专家模型的专家计算;专家负载均衡(EPLB)帮助均匀分配这些工作。
DeepSeek DeepInfer 会组合使用这些并行方式。因此,--ep、--dp 和 --cp 描述的是相互关联的拓扑配置。调整它们时,需要一起检查设备数量、容量和启动器约束。
三、先检查 DeepInfer 的运行条件
在本文核对的版本中,DeepSeek 列出的支持范围如下。
| 项目 | 官方列出的要求 |
|---|---|
| 操作系统 | Linux |
| Python | 3.12 |
| 编译器 | GCC 13.0 或更新版本 |
| NVIDIA 硬件 | SM100 GPU |
| NVIDIA 工具链 | CUDA 13 |
| 华为硬件 | Ascend 950 NPU |
| 华为工具链 | CANN 9.2 |
| 支持的模型系列 | DeepSeek-V4.1-Flash |
安装了 CUDA,不代表显卡一定受支持。同样,一个模型由 DeepSeek 发布,也不代表这个 DeepInfer 版本就能运行它。准备机器之前,应确认实际加速卡架构与模型检查点。
官方离线示例默认使用 --ep 8。这是一种示例拓扑,并不是官方给出的最低显存保证。所需设备数量还取决于模型、显存、上下文长度、批次配置和互连条件。
使用 NVIDIA 设备时,可以先执行下面的环境检查命令。
python3.12 --version
gcc --version
nvcc --version
nvidia-smi
上面命令分别检查 Python、编译器、CUDA 编译器和系统识别到的 GPU。命令能够执行,只是初步检查;还要把实际版本和硬件与 DeepSeek 的运行要求 对照。
四、从源码编译 DeepSeek DeepInfer
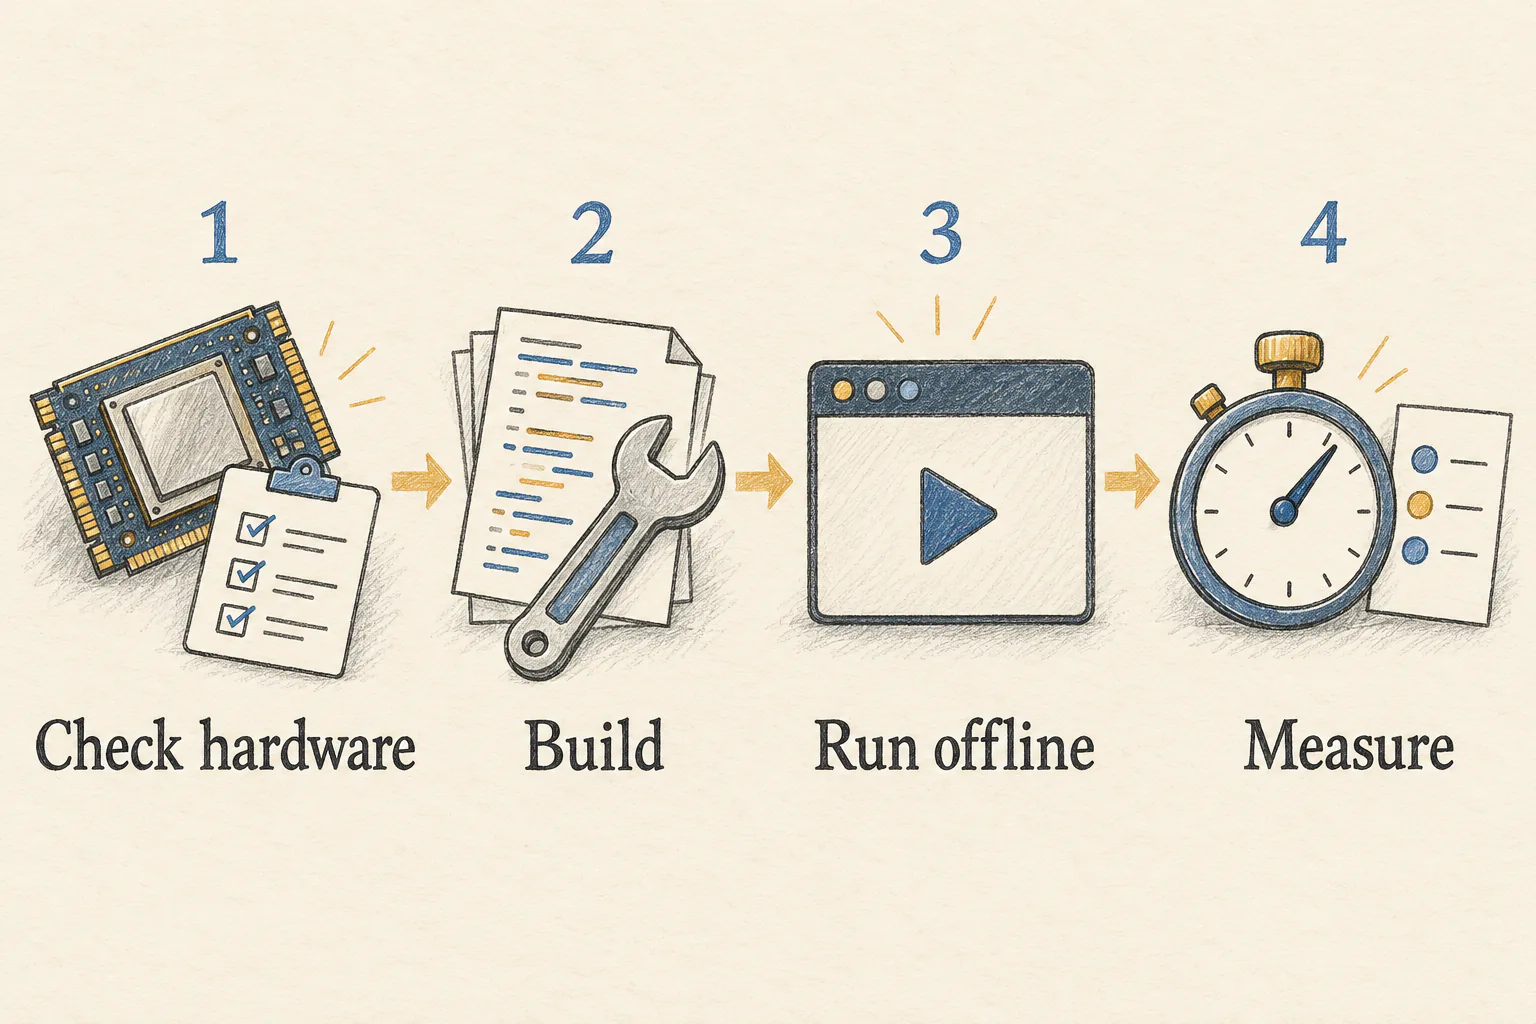
在受支持的 Linux 机器上,先建立独立环境。实际操作可以分成四步:确认平台、编译 DeepInfer、验证离线输出、测量性能。
先获取源码。下面的命令固定到本文核对的提交,避免主分支后续更新影响教程步骤。
org=https://github.com/deepseek-ai
git clone "$org/DeepInfer.git"
cd DeepInfer
git checkout 9bd9cf2
python3.12 -m venv .venv
source .venv/bin/activate
上面命令在项目目录中建立并启用 Python 3.12 虚拟环境。编译和运行 DeepInfer 时,都应保持这个环境处于启用状态。
对于受支持的 NVIDIA 系统,选择加速器类型,再调用仓库的构建脚本。
export \
  DEEPINFER_ACCELERATOR=nvidia
./build.sh
这里的 DEEPINFER_ACCELERATOR 选择 NVIDIA 构建路径。运行 DeepInfer 时也要保留这个环境变量。对于使用 CANN 9.2 的受支持 Ascend 系统,改成 ascend,并完成该平台的环境配置。
构建脚本 会安装平台依赖、构建引入的算子库,再构建 DeepInfer。算子构建脚本 会初始化所需的 Git 子模块。这涉及本地编译和加速器依赖,需要预留编译时间与网络访问条件。
五、运行 DeepSeek 离线推理
编译成功后,在仓库根目录运行官方示例。
python \
  examples/offline_inference.py \
  --ep 8
上面显式写出了示例默认的专家并行规模 --ep 8。其余拓扑配置也必须匹配实际分配到的设备。脚本会运行预设样例,打印生成结果和诊断字段;它的功能是离线推理,不会启动 HTTP 服务。
DeepInfer 的默认模型标识是 deepseek-ai/DeepSeek-V4.1-Flash-1017。首次运行时,如果本地缓存中没有这个检查点,辅助代码会将它下载到 Hugging Face 缓存。开始下载前,应先确认模型文件所需的存储空间。
如果本地已经有完整的 DeepSeek 检查点,可以指定实际目录。
export DEEPINFER_HF_MODEL_DIR=\
/models/DeepSeek-V4.1-Flash-1017
python \
  examples/offline_inference.py \
  --ep 8
上面代码中的 /models/DeepSeek-V4.1-Flash-1017 要替换成自己的目录。目录里需要有模型配置和权重,不能只是一个空文件夹。这个变量只重定向默认模型,不会覆盖显式传入的 --model_name。
运行时,可以观察生成文本、输出词元数、草稿词元接受情况和 decode_ppl 诊断信息。运行成功说明模型与引擎能够在当前配置下配合工作;应用准确率和生产容量还需要另行评估。具体行为见 DeepInfer 离线示例 与模型加载代码。
六、让 DeepInfer 处理自己的提示词
官方示例在 examples/_prompts.py 中组织测试提示词。先运行未经修改的示例,再在 main() 中加入一小段代码,就能复用已经初始化的 llm 和分布式配置。
把下面的代码放到 examples/offline_inference.py 中的 llm.close() 之前,并按照函数体的缩进方式对齐。
from deepinfer import (
    sampling_params as sp,
)

prompt = (
    "Complete this sentence: "
    "A useful software test should"
)
params = sp.SamplingParams(
    temperature=0, max_tokens=64,
)
outputs = llm.generate(
    prompts=[prompt],
    sampling_params=params,
    use_tqdm=False,
)
tokens = [t.token_id
          for t in outputs[0]]
text = llm.get_tokenizer().decode(
    tokens,
    skip_special_tokens=True,
)
print(text)
上面代码中,llm 是现有引擎,max_tokens 限制生成长度,最后几行把词元对象解码成文本。这段代码需要插入已有示例,不能单独完成初始化。存在多个数据并行工作进程时,每个进程都会执行这段新增代码。
这里有意使用普通续写提示词。聊天应用应采用所选 DeepSeek 检查点要求的输入格式,不要直接把托管 API 的 messages 字典当成这个 Python 接口的输入。接口定义可以查阅 DeepInfer 的 LLM 入口。
七、使用 DeepSeek DeepInfer 输出 JSON
假设一个应用要把客服工单分到 billing、bug 或 other。一段自然语言方便人阅读,而固定格式的 JSON 对象更方便程序处理。
DeepInfer 支持通过正则表达式、JSON Schema 和 EBNF 语法约束生成。可以先运行仓库自带的检查。
python \
  examples/offline_inference.py \
  --ep 8 --check_structured_output
上面参数会在普通样例完成后,复用已经加载的 DeepSeek 模型,检查结构化输出案例及正常终止行为。
接着,把上一节的自定义代码替换为下面的代码,仍然放在已经完成初始化的 main() 函数中。
import json
from deepinfer import (
    sampling_params as sp,
)

schema = {
    "type": "object",
    "properties": {
        "route": {
            "type": "string",
            "enum": [
                "billing", "bug",
                "other",
            ],
        },
    },
    "required": ["route"],
    "additionalProperties": False,
}
schema_json = json.dumps(schema)
params = sp.SamplingParams(
    temperature=0, max_tokens=64,
    so_args={
        "schema_type": "json",
        "schema": schema_json,
    },
)
上面代码中,schema 定义允许返回的对象,params 把它交给 DeepInfer 的采样器。然后在同一个函数中继续加入工单输入与结果解码。
prompt = (
    "Route this ticket: "
    "I was charged twice. "
    "Return JSON."
)
outputs = llm.generate(
    prompts=[prompt],
    sampling_params=[params],
    use_tqdm=False,
)
tokens = [t.token_id
          for t in outputs[0]]
text = llm.get_tokenizer().decode(
    tokens,
    skip_special_tokens=True,
)
print(json.loads(text))
这个例子要求输出包含一个 route 字段,并限制它可以使用的字符串。json.dumps(schema) 采用了 DeepSeek 结构化输出示例 所使用的参数形式。
这张工单的预期分类是 billing,它不是本文实测得到的输出。约束生成只能控制格式与允许的值。你仍然需要检查分类是否正确、生成是否正常结束,以及程序能否处理失败或截断的响应。
八、怎样阅读 DeepInfer 的性能数据
先确认 DeepSeek DeepInfer 能在自己的硬件上生成有效结果,再测性能。每次测量都应记录源码版本、模型检查点、加速卡型号、设备数量、上下文长度、批次和推测解码配置。
下面以单个节点、八张受支持的 NVIDIA 设备为例,显式指定设备,并在测量时关闭性能分析器。
export WORLD_SIZE=1 RANK=0
export CUDA_VISIBLE_DEVICES=\
0,1,2,3,4,5,6,7
PROFILE=0 \
  python examples/benchmark.py \
  --prompt_mode text \
  --decode_num_requests 8 \
  --result_jsonl results.jsonl
这里的 WORLD_SIZE 在示例启动器中表示节点数量。可见设备列表也参与推导并行规模,要按实际分配到的设备修改。它不是通用的最低硬件配置。
DeepInfer 的测试脚本分别控制预填充与解码。例如,--prefill_batch_size 控制预填充分块,--decode_num_requests 控制解码批次。增大其中一个参数,并不等于另一个也随之增大。
阅读 DeepSeek 的吞吐量数据时,还要注意统计口径。示例文档采用草稿全部接受的折算口径计算解码吞吐量,即使实际接受率有所不同。这个数字不等于只统计最终接受并交付给用户的输出词元。比较结果时,应说明接受率假设,同时观察延迟和实际输出。
DeepInfer 首页图表的预填充测试使用四张 SM100 GPU,解码测试使用 64 张,每项测试都位于一个纵向扩展域内。它们描述的是这些特定配置,不能直接预测上面八卡命令的表现。详见测试方法 与官方性能说明。
九、三个值得了解的 DeepInfer 配置
先保留一个能正常运行的基线,每次只改一个参数,同时比较结果正确性与运行表现。
本文核对的 DeepInfer 版本提供下面几个控制项。
DEEPINFER_USE_NEXTN_DECODE控制最大草稿长度。文档默认值是 5;在示例中设为 0 可以关闭推测解码。DEEPINFER_ENABLE_MTP_VARLEN=1启用文档介绍的 DSpark 与基于置信度的验证调度路径。DEEPINFER_BATCH_INVARIANT=1在受支持的 NVIDIA 路径上启用批次不变推理。
DeepSeek 给出的确定性采样配置,还要求在批次不变性之外设置 DEEPINFER_ENABLE_MTP_VARLEN=0,并在 SamplingParams 中传入固定的 seq_seed。只设置随机种子,并不是完整的配置。平台限制与参数说明见 DeepInfer 功能配置。
十、完整的 DeepSeek 生产服务还需要什么
公开的 DeepInfer 版本提供了引擎基础。DeepSeek 明确列出了完整推理服务还需要、但本次开源没有作为完整服务实现提供的三部分。
- KV cache 系统,在服务层面管理可复用的注意力状态。
- 将视觉编码、预填充与解码拆分成服务阶段;多数所需引擎能力已经具备。
- 在预填充与解码的数据并行副本之间进行负载均衡。
这不意味着引擎在内部完全不维护注意力状态。官方说明区分的是引擎本身的能力,以及围绕引擎构建的完整服务系统。
自己部署时,还要规划请求准入、认证、监控、故障处理和容量限制。这些属于应用与运维工作,本文没有提供一套已经完成的在线服务栈。
项目之间的关系也需要说清楚。DeepSeek 表示,DeepInfer 最初主要基于 vLLM 构建,同时借鉴了 SGLang 和 TensorRT-LLM。这样的开发背景,并不自动意味着命令行或服务接口可以直接互换。具体使用方式应以 DeepInfer 仓库为准。
十一、关于 DeepSeek DeepInfer 的常见问题
DeepInfer 是新的 DeepSeek 模型吗?
不是。DeepInfer 是推理软件。本文核对的版本明确支持 DeepSeek-V4.1-Flash 模型系列,模型权重需要单独加载。
笔记本或任意 CUDA 显卡能运行 DeepInfer 吗?
文档列出的目标平台是 Linux,以及 NVIDIA SM100 或华为 Ascend 950 加速卡。这个版本没有在 README 中提供纯 CPU、macOS 或通用消费级显卡的运行路径。
DeepInfer 能运行所有 DeepSeek 检查点吗?
不能直接这样假设。换模型前,应检查支持列表和加载器。发布者相同,不代表模型架构一定兼容。
离线命令会启动兼容 OpenAI 的服务吗?
不会。它运行离线样例。HTTP 服务还需要额外集成,以及前面介绍的服务组件。
DeepInfer 能保证每个答案都正确吗?
不能。执行速度、JSON 格式和答案正确性是不同的问题。你需要用实际任务评估 DeepSeek 模型,包括困难输入与失败情况。
十二、从哪里开始
DeepSeek DeepInfer 让模型执行层变得更容易研究:DeepSeek 模型如何加载,计算如何协调,词元如何生成。对于在受支持平台上研究或运维推理的工程师,它提供了具体的代码与运行入口。
先准备兼容的机器,运行未经修改的离线示例。确认成功后,再加入一个简单提示词,按需求验证结构化输出,并测量自己的实际任务。这样才能判断 DeepInfer 是否适合自己的 DeepSeek 部署。
主要资料是 DeepInfer 仓库、示例指南 和 Apache 2.0 许可证。文中配图为原创 AI 概念插画,不是产品截图或性能测量结果。