AI 与 API
Muse Wonder 入门
从一个小任务开始,了解 Meta Muse Wonder,使用多模态 Playground 和 API 提交文本、图片、视频、音频与 PDF,并读懂输入、输出和 credits 计费。
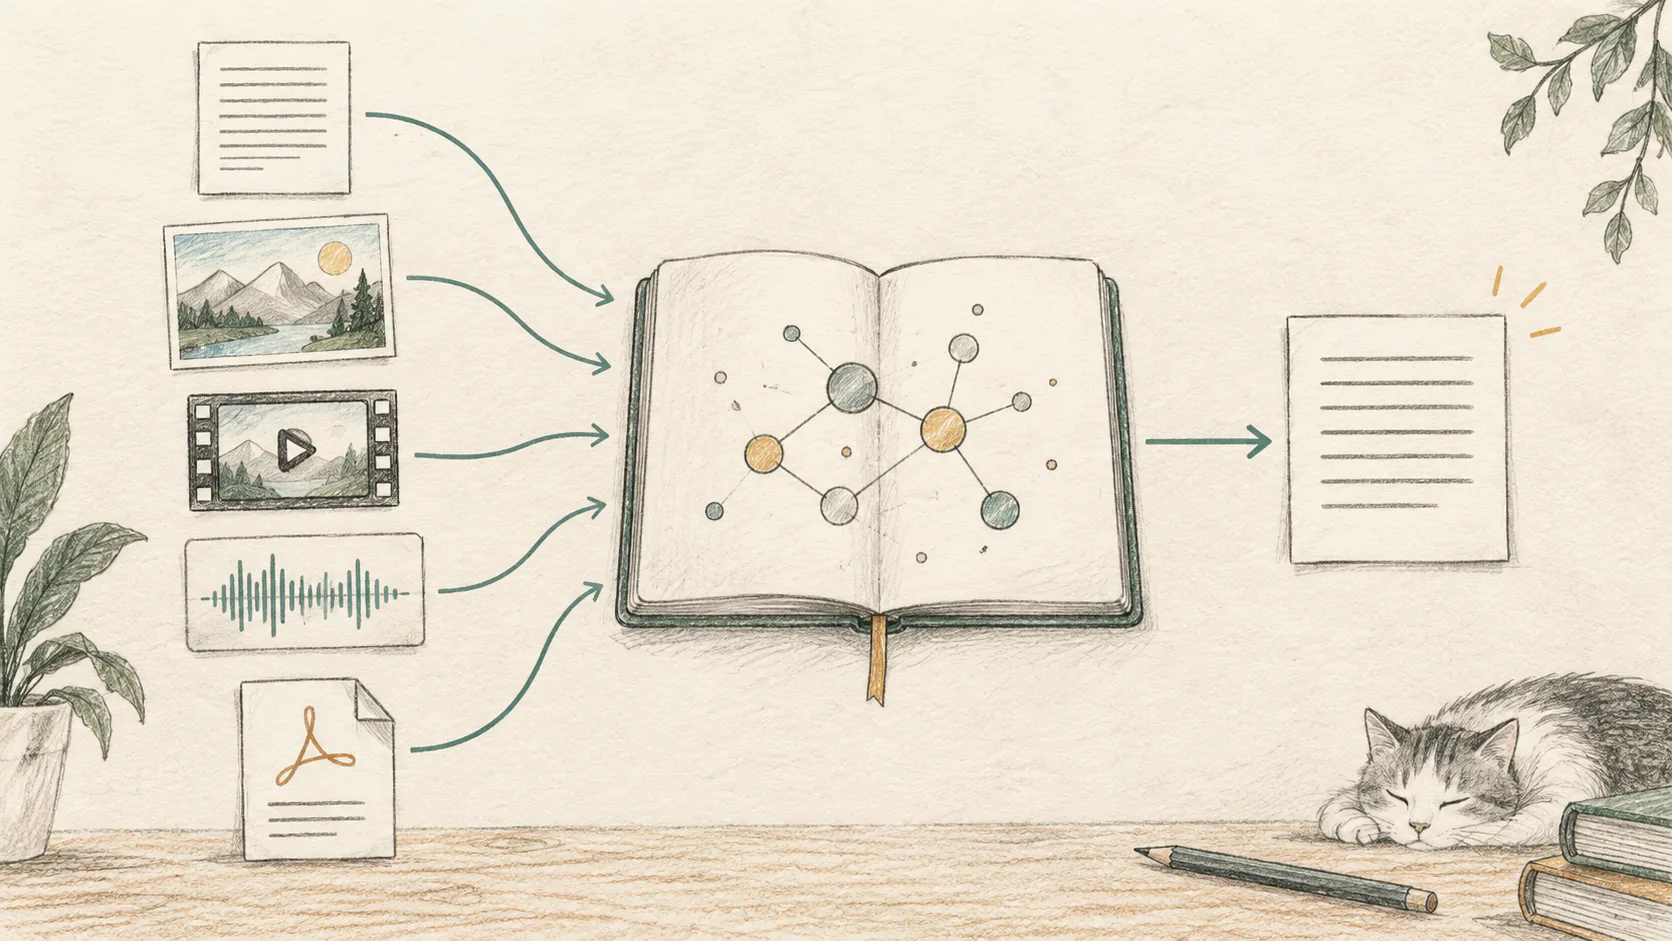
Muse Wonder 是 Meta 的多模态推理模型,可以结合不同类型的材料,回答问题、分析文档和辅助编程。Meta 于 2026 年 10 月 12 日发布了这个系列。官方介绍
实际工作里的材料经常混在一起:任务写在文字里,流程画在图片里,补充说明又放在录音里。使用模型前,首先要弄清楚这些材料应该怎样交给它。
下面从一个小任务开始,依次介绍 Muse Wonder 是什么、怎样在线体验、怎样调用 API,以及如何看懂费用。
一、先从一个具体场景开始
假设你要整理一次项目讨论。手边有几行进度记录、一张流程图,以及一份 PDF 方案。你希望得到一段说明:已经完成什么,还有哪些问题,以及下一步应该做什么。
所谓「多模态(multimodal)」,就是模型可以处理多种信息形式。这个场景里,文字、图片和 PDF 都是输入;你要求的总结是输出。
OpenRouter 的 Muse Wonder 模型目录列出了文本、图片、视频、音频和 PDF 输入,输出为文本,上下文窗口为 1,048,576 tokens。音频等能力应以实际使用的服务入口为准。模型目录
| 手里的材料 | 可以提出的问题 |
|---|---|
| 文本记录 | 提取进度、负责人和待办事项 |
| 图片或截图 | 解释流程、表格或界面信息 |
| 视频 | 概括片段中的事件 |
| 音频 | 总结录音中的主要内容 |
| 根据文档回答具体问题 |
Meta 还发布了 Muse Wonder Full。官方将普通 Muse Wonder 提供给 Meta Model API 和 Muse Code,将 Full 提供给特定 Muse Code 订阅计划。本文使用的模型 ID 是 meta/muse-wonder。开发者说明
二、用四步理解一次调用
先把过程拆成四步。
(1)准备问题,以及回答它真正需要的材料。
(2)把文字和附件组织成一条消息。
(3)把消息发给模型,等待处理。
(4)读取文本回答,同时查看输入、输出和费用。
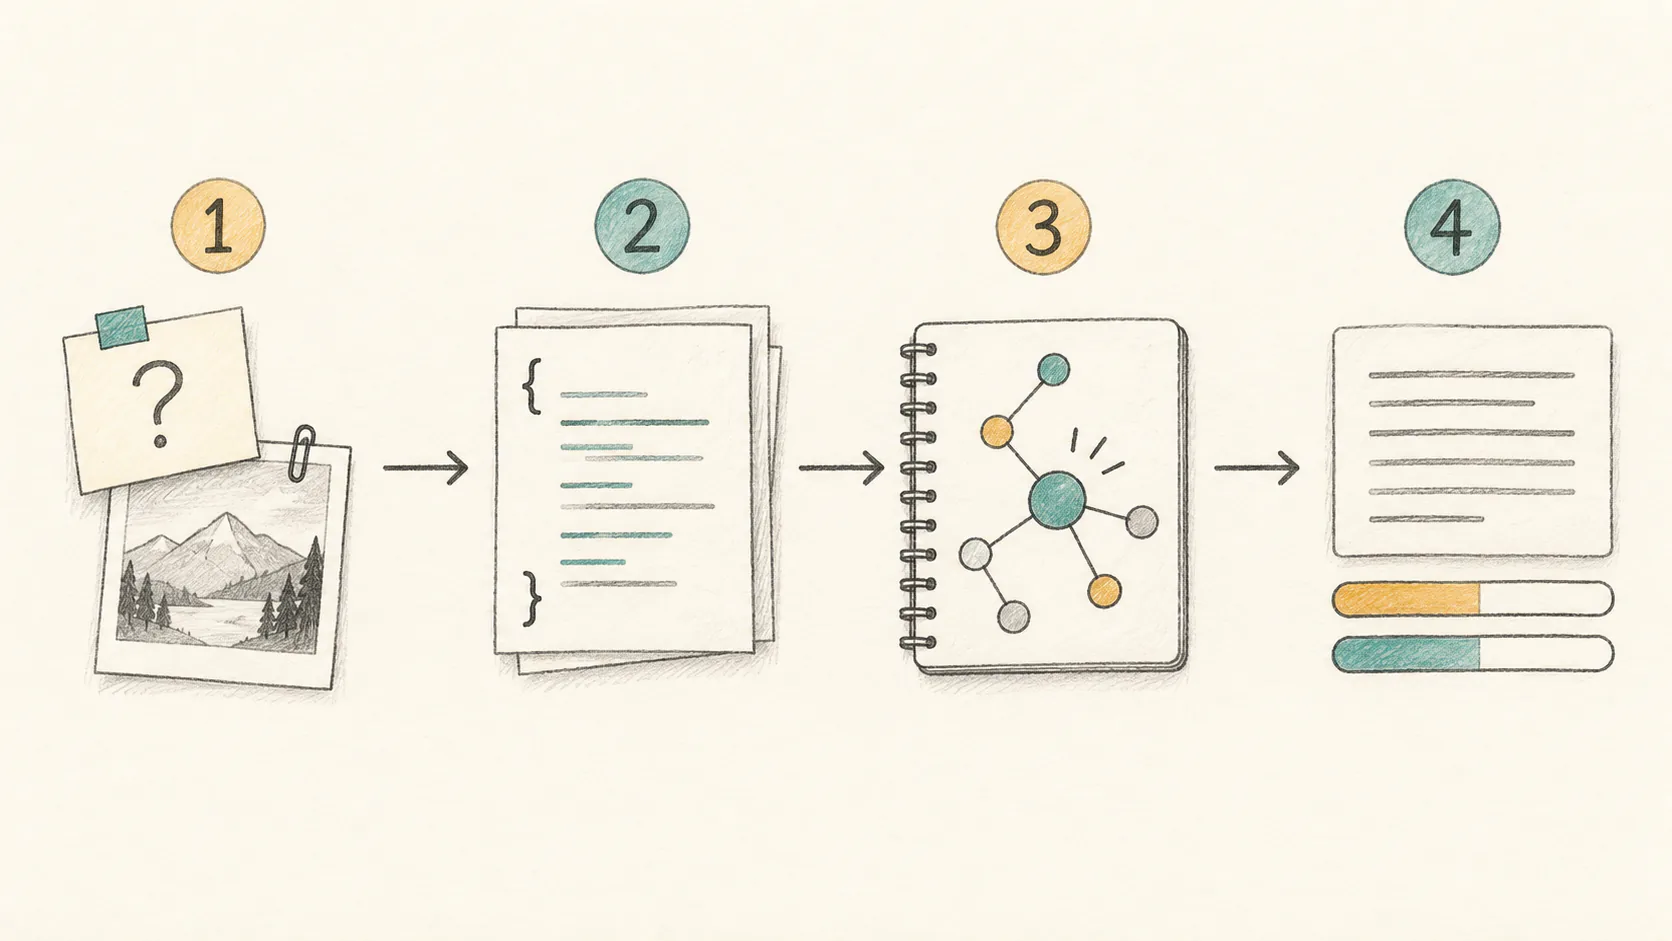
API 里的「消息(message)」就是一次发言。纯文本可以直接放进 content;加入图片等材料时,content 就改成由多个内容片段组成的数组。
这个区别理解了,后面的请求就容易看懂。
三、先用在线界面体验
如果希望先验证自己的材料是否适合这类模型,可以使用我们的 Decisions API 多模态 Playground。它把在线对话、附件输入、用量显示和后续 API 接入放在同一个产品里。先从 Muse Wonder 模型页 查看能力、价格和当前限制,再开始测试。
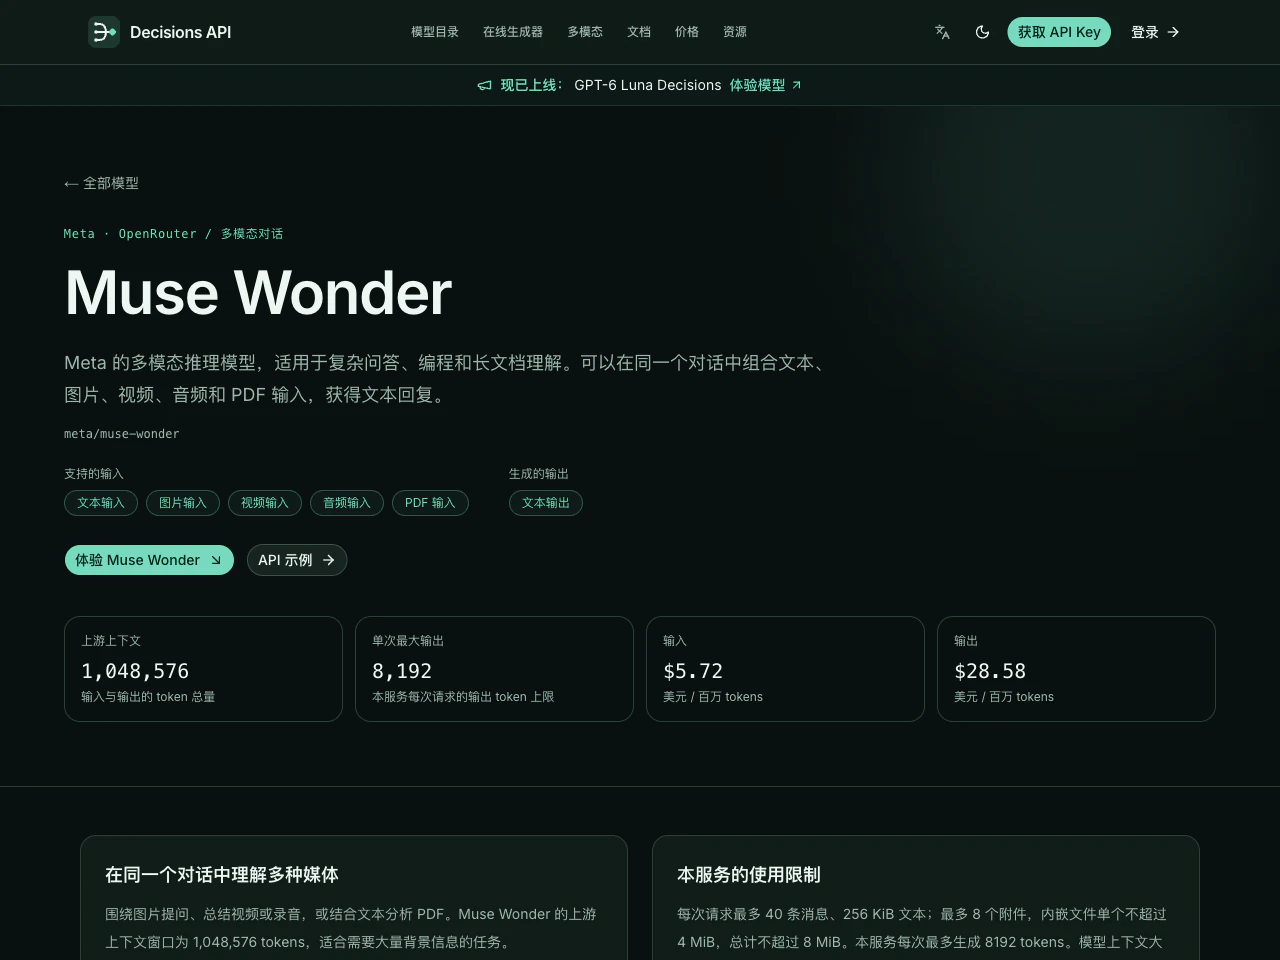
操作顺序如下。
(1)登录账户,并确认有足够的 credits。发送请求前,服务会预留一部分余额。
(2)第一次先发送纯文本。例如,提供「周二完成接口,周三开始联调,移动端登录仍待修复」这段记录,再要求模型整理「已完成事项、问题和下一步」。
(3)需要图片时,点击「添加媒体」,选择一张清楚的图片。也可以保存本文的概念插图,用它测试信息流程的理解。
(4)输入「请概括附件中的信息流程,并分别列出支持的输入和最终输出」,把最大输出先设为 256,然后发送。
这里保留的是已填写问题、已选择附件的真实界面,尚未发送请求。
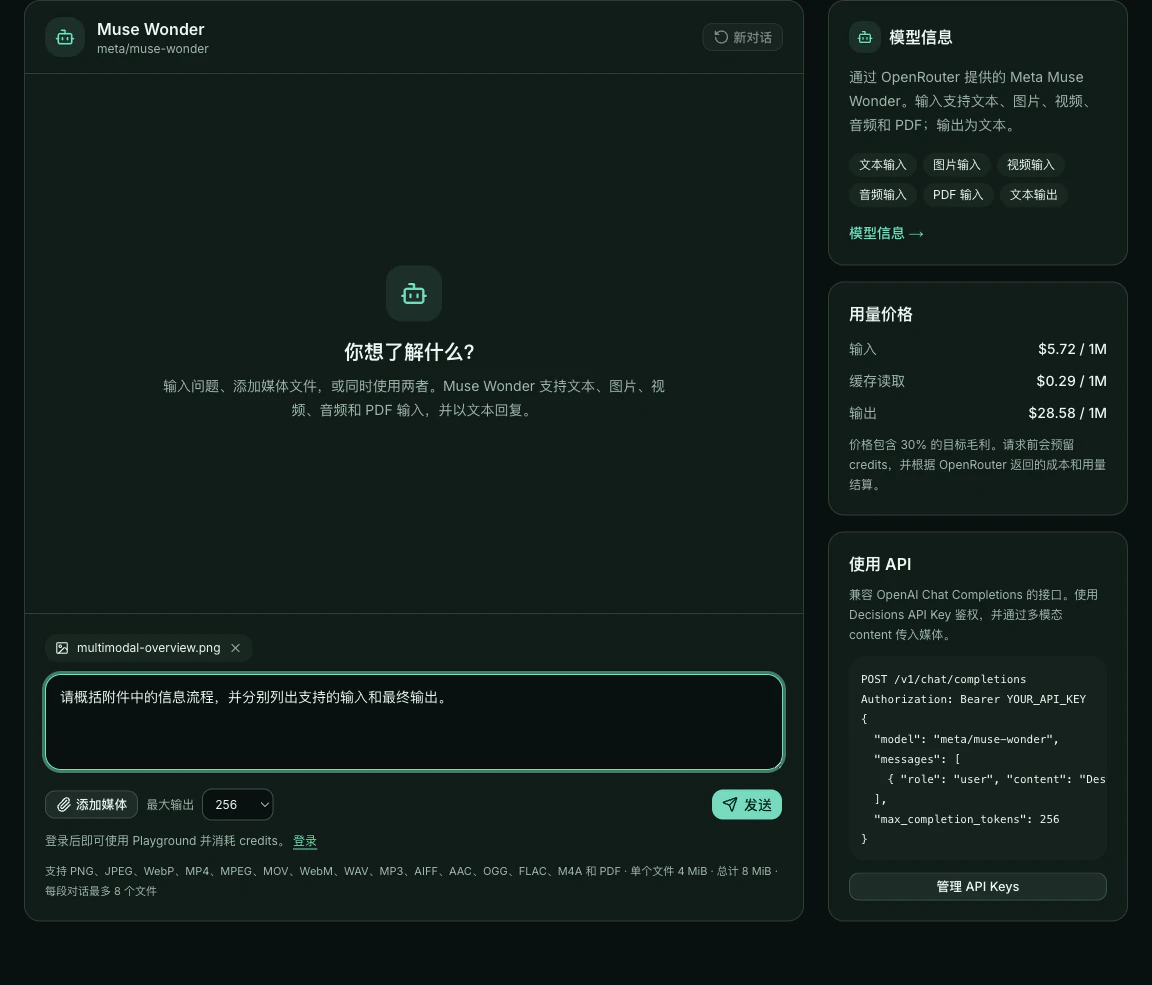
回复后,可以查看 token 用量和扣除的 credits。需要追问时,在同一个对话里补充条件;切换到另一项任务时,使用「新对话」。
四、用 API 发出第一条消息
在线体验之后,再把相同的任务接进自己的程序。先在账户的 API Keys 页面 创建密钥,并将它保存为本机环境变量 DECISIONS_API_KEY。浏览器里的前端代码不要直接保存这个密钥。
下面是一个完整的文本请求,可以在终端运行。先将 YOUR_API_KEY 替换为刚创建的密钥。
export DECISIONS_API_KEY='YOUR_API_KEY'

curl --fail-with-body -sS https://decisions-api.dev/v1/chat/completions \
  -H "Authorization: Bearer $DECISIONS_API_KEY" \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "meta/muse-wonder",
    "messages": [{
      "role": "user",
      "content": "Project notes: API finished Tuesday; integration starts Wednesday; mobile login still needs a fix. Summarize completed work, blockers, and next steps."
    }],
    "max_completion_tokens": 256,
    "stream": false
  }'
上面代码中,model 选择具体模型,messages 提供任务和材料。max_completion_tokens 限制单次输出的 token 数量;本站当前使用 stream: false,一次返回完整响应。
这个请求使用本站的密钥和地址。如果改用 Meta 或 OpenRouter 的直接接口,需要同时按对应文档修改地址、密钥和模型命名。
五、把图片、视频或音频放进消息
先看图片。保留前面的请求结构,把用户消息的 content 替换为下面的数组。
[
  { "type": "text", "text": "Explain this diagram. List its inputs and output." },
  {
    "type": "image_url",
    "image_url": { "url": "https://img.lovableapp.org/articles/muse-wonder-guide/multimodal-overview-38f8303c04a35bfc.webp" }
  }
]
上面代码中,第一个片段提出问题,第二个片段提供图片。示例 URL 指向本文的原创概念插图,可以替换成自己的公开 HTTPS 图片地址。
其他媒体使用相同的「文字问题 + 媒体片段」结构,字段各有不同。
| 输入 | 内容片段类型 | 媒体数据放在哪里 |
|---|---|---|
| 图片 | image_url |
image_url.url,使用公开 HTTPS URL 或支持的 data URL |
| 视频 | video_url |
video_url.url,使用公开 HTTPS URL 或支持的 data URL |
| 音频 | input_audio |
input_audio.data 放 base64,format 写音频格式 |
file |
file.filename 写 PDF 文件名,file.file_data 放 URL 或 PDF data URL |
例如,Python 可以把本地 WAV 音频转换为请求所需的内容片段。
import base64
from pathlib import Path

audio = base64.b64encode(Path("meeting.wav").read_bytes()).decode("ascii")
part = {"type": "input_audio", "input_audio": {"data": audio, "format": "wav"}}
上面代码中,data 只包含 base64 数据,不带 data: 前缀。把 part 加入用户消息的 content 数组,并在它前面放一段说明任务的文本即可。
OpenRouter 对多模态请求也采用这种按类型组织内容的方式;使用前还要确认选定模型和服务支持对应输入。多模态文档
六、读懂回答和费用
把响应 JSON 解析为 result 后,可以先读取下面几个字段。
console.log(result.choices[0].message.content);
console.log(result.usage.prompt_tokens, result.usage.completion_tokens);
console.log(result.credits_used, result.charged_cost_usd);
上面代码中,第一行读取文本回答,第二行读取输入和输出 tokens,第三行读取本站实际扣除的 credits 和对应美元金额。后两个字段是本站的计费扩展。
Token 是模型计量文本等输入、输出的单位,不能简单等同于字数或文件大小。加入媒体、增加历史消息,都会影响一次请求的实际用量。
截至 2026 年 10 月 13 日,价格对照如下。单位为美元 / 百万 tokens。OpenRouter 价格
| 用量类型 | OpenRouter 公布价格 | 本站展示价格 |
|---|---|---|
| 输入 | $4.00 | $5.72 |
| 缓存读取 | $0.20 | $0.29 |
| 输出 | $20.00 | $28.58 |
举例来说,1,000 个非缓存输入 tokens,加上 200 个输出 tokens,按本站展示费率粗算约为 $0.0114。实际按上游报告成本结算,并向上取整为 credits;这个例子在无额外费用时约扣 115 credits,也就是 $0.0115。
预留金额与最后扣款可能不同。预留需要覆盖预计输入和允许的最大输出,完成后再按实际用量结算;每次成功请求最低扣除 1 credit。长对话每轮还会重新提交历史消息,所以追问也有输入成本。
七、第一次使用时,记住几个边界
模型的上游上下文为约 100 万 tokens,本站还有独立的请求限制:最多 40 条消息、256 KiB 文本、8 个附件;内嵌附件单个不超过 4 MiB,总计不超过 8 MiB。单次输出上限为 8,192 tokens。
内嵌图片支持 PNG、JPEG、WebP;视频支持 MP4、MPEG、MOV、WebM;Playground 音频支持 WAV、MP3、AIFF、AAC、OGG、FLAC、M4A。先用一个小文件确认流程,再逐步增加材料。
Meta 介绍的工具使用和跨对话记忆,需要相应应用配合。本站当前接入的是消息与媒体对话,客户端需要提交历史消息;刷新 Playground 会清空当前页面的对话。传入 tools 或 response_format 也不会在当前中转中启用对应功能。
遇到错误时,先检查 HTTP 状态:401 通常需要检查登录或 API Key,402 表示余额不足以完成预留,400 则应检查参数和媒体格式。API 响应的 error.message 会提供更具体的线索。
开始时,一个小任务就够了:给出清楚的问题,提供必要材料,限制回答长度,再核对结果是否符合原始材料。掌握这个过程后,就可以把同样的消息结构接入自己的应用。
(完)