AI 与 API
Muse Wonder 与 Opus 5.5 对比
从登录故障工单出发,比较 Muse Wonder 与 Opus 5.5 的输入能力、价格和公开评测,读懂 14 项成绩表,并用四步方法评估质量、总成本和人工返工。
Muse Wonder 和 Claude Opus 5.5 都是可以处理复杂任务的推理模型。前者来自 Meta,后者来自 Anthropic。它们都能分析材料、辅助编程,也都可以成为代理应用里的一个模型。
选型的困难在于,价格表、排行榜和真实工作回答的是不同问题。价格表告诉你每个 token 的费率;排行榜反映一组任务的成绩;你的产品还要考虑输入格式、等待时间和人工返工。
下面用一张故障工单串起这次比较:先看材料能否进入模型,再看公开成绩和费用,最后设计一个自己能重复的小测试。价格和资料核对日期为 2026 年 10 月 13 日。
本文整理公开资料并提供评估方法,文中的分数均注明来源。界面截图展示准备步骤,不代表我们已完成两模型对跑。
一、先拿出一张工单
假设登录页面发布后,部分 Android 用户又被送回登录页。你有部署时间、错误日志、页面截图,还有用户录下的一段操作视频。你希望模型整理已知事实、提出待验证假设,并给出下一步检查。
这份任务至少有两个问题:它能不能理解这些材料?理解以后,建议是否有证据支持?
Muse Wonder 的模型卡列出文本、图片、视频和音频输入,输出为文本。Opus 5.5 的公开规格列出文本和图片输入。两者都有约 100 万 tokens 的上下文窗口。Meta 模型卡,Opus 5.5 规格
因此,直接提交视频或录音时,Wonder 值得先检查。Meta 也提醒,音频是否可用要以实际服务入口为准。给 Opus 使用这类材料时,通常需要先转录或抽帧,并把这一步的成本与信息损失一起记下来。Meta 开发者说明
上下文大,只表示一次能容纳更多信息,不能保证模型找得到每个关键细节。故障诊断仍应要求它区分「材料里已有的事实」与「下一步才能验证的推测」。
二、先确认比较的是哪个版本
这里比较的是通过 API 使用的普通 Muse Wonder,以及 Claude Opus 5.5。
Meta 同时发布了 Muse Wonder Full,但目前将 Full 放在 Muse Code 的指定订阅计划中。普通 Wonder 的 API 名称与 OpenRouter 名称也不同。官方接入说明
| 入口 | 模型名称或 ID | 在本文中的作用 |
|---|---|---|
| Meta Model API | muse-wonder-1.0 |
普通 Wonder 的官方 API |
| OpenRouter | meta/muse-wonder |
普通 Wonder 的中转标识 |
| Muse Code 指定订阅 | Muse Wonder Full | 单独的版本,不能拿它的分数替代普通版 |
| Claude API | claude-opus-5-5 |
Opus 5.5 的官方 API |
模型 ID 与接入入口见 Meta 文档、OpenRouter 模型页 和 Anthropic 模型页。
还要确认你使用的是聊天界面、原始 API,还是配好工具的代理。模型能提出工具调用,不等于一个聊天接口已经替你执行命令、读取仓库或保存长期记忆。
三、同样的单价,为什么账单不同
先看标准 API 公布的基础费率,单位为美元 / 百万 tokens。
| 类型 | Muse Wonder | Opus 5.5 |
|---|---|---|
| 普通输入 | $4.00 | $4.00 |
| 缓存读取 | $0.20 | $0.20 |
| 输出 | $20.00 | $20.00 |
两家的这三项单价相同。Meta 定价,Anthropic 定价
如果只计算 10,000 个非缓存输入 tokens 和 2,000 个计费输出 tokens,两者基础 token 费用都是 $0.08。这是给定用量的算术例子,实际运行不一定产生相同用量。
长任务会反复提交上下文,可能命中缓存,也可能重试。推理过程、工具结果和最终答案会影响实际账单。不同模型的分词方式也不完全相同,同一份文字不必然得到同样的 token 数。
Anthropic 还单列缓存写入费率:5 分钟为 $5、1 小时为 $8 / 百万 tokens;异步 Batch API 的输入与输出有 50% 折扣。Meta 的上述发布页没有列出对应批次折扣。比较时应固定使用的服务模式,而不是把一家的批次价与另一家的实时价放在一起。Anthropic 计费说明
Artificial Analysis 的发布评估提供了一个有意思的组合:Wonder 在 max 设置下,Intelligence Index 为 52,索引加权单任务成本为 $4.52;Opus 5.5 在 max、默认 fallback 设置下,分别为 58 和 $5.98。Wonder 评估,Opus 评估
这说明「每 token 同价」「综合分数不同」「一次测试的花费不同」可以同时成立。这里的单任务成本是该机构按索引权重计算的指标,也不能直接当成你的每张工单成本。
四、把“14 项里赢 5 项”读成线索
按 Meta 发布表中普通 Wonder 和 Opus 5.5 的 14 行分数逐项计数,Wonder 有 5 行较高,Opus 有 9 行较高。这个说法确实能从官方表格复核出来。Meta 成绩表
挑出四行,就能看到编码任务内部也有差异。下面都是 Meta 发布表中的分数,越高越好。
| 测试 | 普通 Wonder | Opus 5.5 |
|---|---|---|
| DeepSWE 1.1 | 78.8 | 74.2 |
| SWE-Marathon | 53.1 | 46.3 |
| Terminal-Bench 4.0-AA | 52.0 | 59.6 |
| ProgramBench | 50.0 | 70.5 |
数据来自 Meta 发布表。前两项偏向长程软件工程,后两项分别涉及终端任务和完整程序重建,不能简单合成一句「编码更强」。
分数旁边的注释同样重要。模型卡说明,DeepSWE 的这两个模型结果来自 Datacurve;SWE-Marathon 采用外部结果,整行并非统一代理框架下的受控比较;部分竞争模型的内部运行也只是尽力对齐配置。评估方法与限制
另外,14 行不是 14 次独立的业务投票,综合指数与单项测试还有重合。Wonder 在 GDP.pdf 的 30.8 对 30.6,也缺少足以支持「稳定胜出」的误差说明。更稳妥的做法,是把这些数字当作候选任务的线索。
我的选型建议是:通用编码和知识任务,可以先用 Opus 5.5 建立基线;长程工程任务和原生音视频输入,把 Wonder 加入候选。这个建议来自公开数据的取舍,最终仍要由自己的验收结果决定。
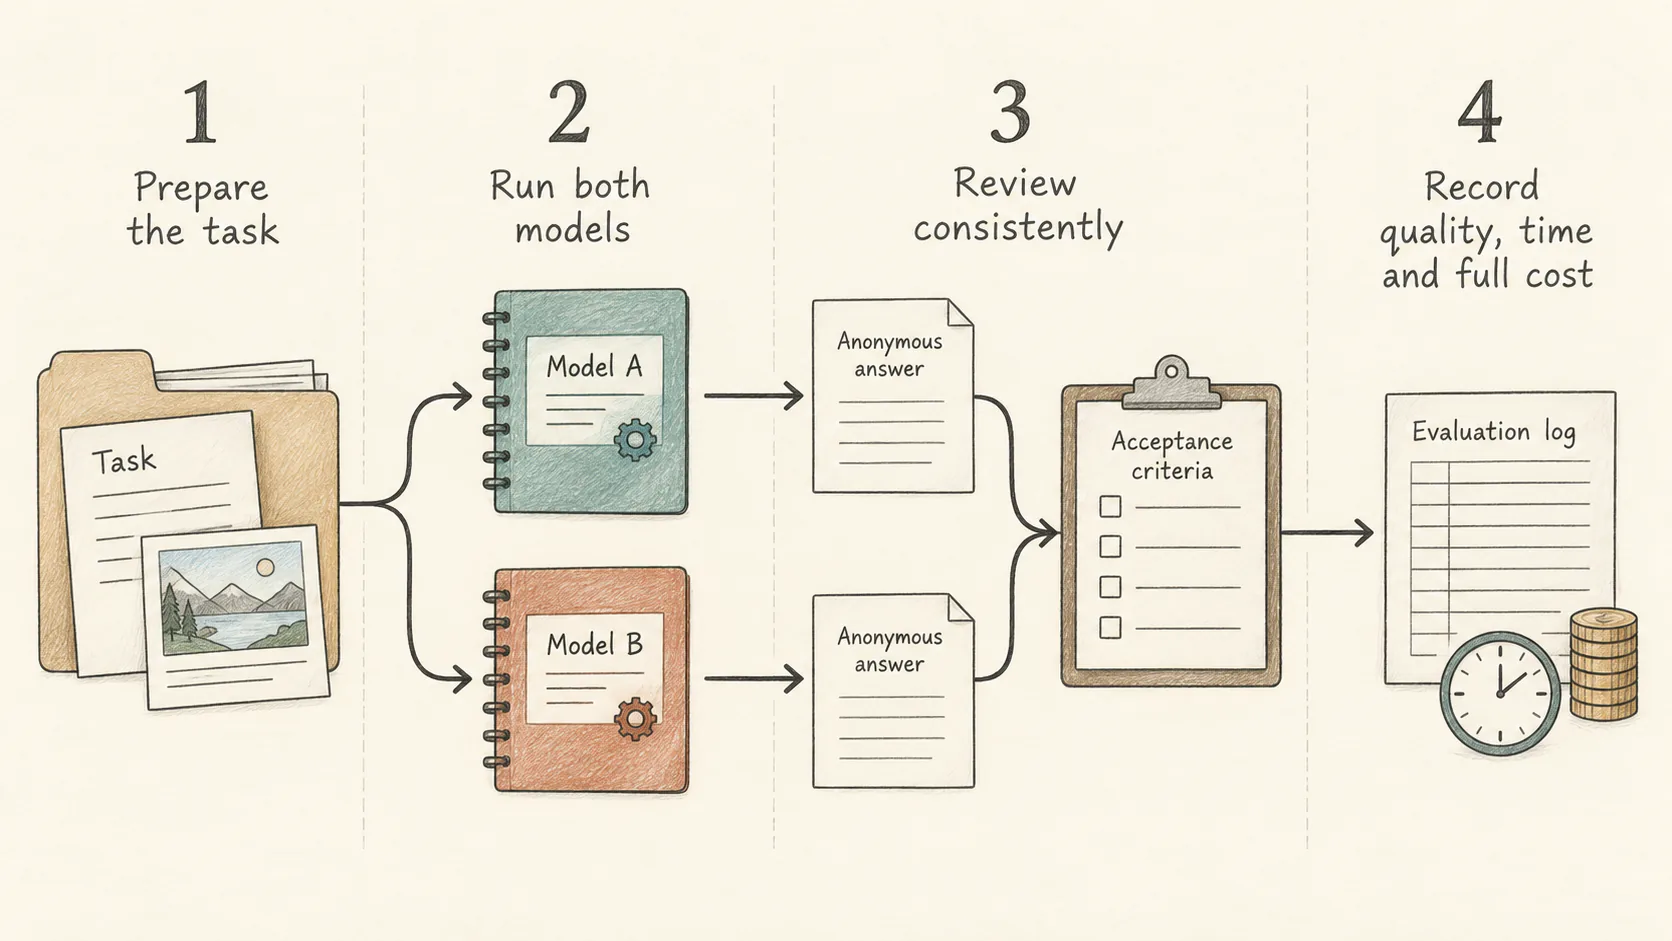
五、四步做一个可重复的比较
回到登录故障。先比较「根据已有材料提出检查计划」,再单独比较「有仓库和工具时完成修复」。两个阶段需要的权限、上下文和验收标准不同。
(1)固定一份材料包。文本与图片任务给两者相同证据;视频、音频任务则分别记录原生处理与转录、抽帧的完整流程。
(2)固定验收标准。例如,是否区分事实与假设,是否引用材料,是否遗漏关键线索;若要求修改代码,则预先确定测试和允许修改的范围。
(3)记录配置并重复运行。保存模型版本、推理设置、工具、提示和输出上限。同名的 max 不代表两个模型使用相同计算量,适合再比较一组相近的时间或费用预算。
(4)隐藏模型名称后评审,再记录总费用和人工修改时间。保留失败与重试,不只选最好的一次。
下面这段提示可以作为文本分析阶段的起点。
材料:10:02 部署登录页面;10:05 Android 用户报告登录后又回到登录页;桌面端暂未复现。
任务:分别列出已知事实、待验证假设、下一步检查。
要求:每条结论注明材料依据;没有依据时明确说明。
限制:不要把假设写成结论,不要声称已经执行检查。
上面提示固定了输入事实和评审重点。它适合检查推理是否克制;真正的修复任务还需要代码、运行环境和可执行的验收条件。
费用可以多看一个指标:「每个通过验收的任务花了多少钱」。下面使用两组虚构汇总数字说明计算方法,并非两模型的实测。
def cost_per_accepted(total_usd, accepted):
    return total_usd / accepted if accepted else float("inf")

print(cost_per_accepted(30, 60))  # 0.50 USD
print(cost_per_accepted(40, 90))  # about 0.44 USD
上面代码中,总费用要包含失败与重试的模型费用,以及实际发生的工具或预处理费用。第二组花的钱更多,但每个验收通过的任务成本更低;人工评审时间另列,便于判断是否值得。
六、先把 Wonder 的这一侧跑起来
想先准备 Wonder 的材料,可以使用我们的 Decisions API 多模态 Playground,并在 独立模型页 查看价格和限制。完整的密钥与 API 步骤见 Muse Wonder 入门。
(1)登录并确认余额,先粘贴上一节的文字材料。
(2)为这个短文本任务把最大输出设为 256。若回答被截断,增加上限,并在评估记录里记下变化。
(3)发送后保留回答、用量和实际扣费,再到你使用的 Claude 服务里执行同一项文本任务。
这里是真实界面里已经填好的案例,截图停在发送前。
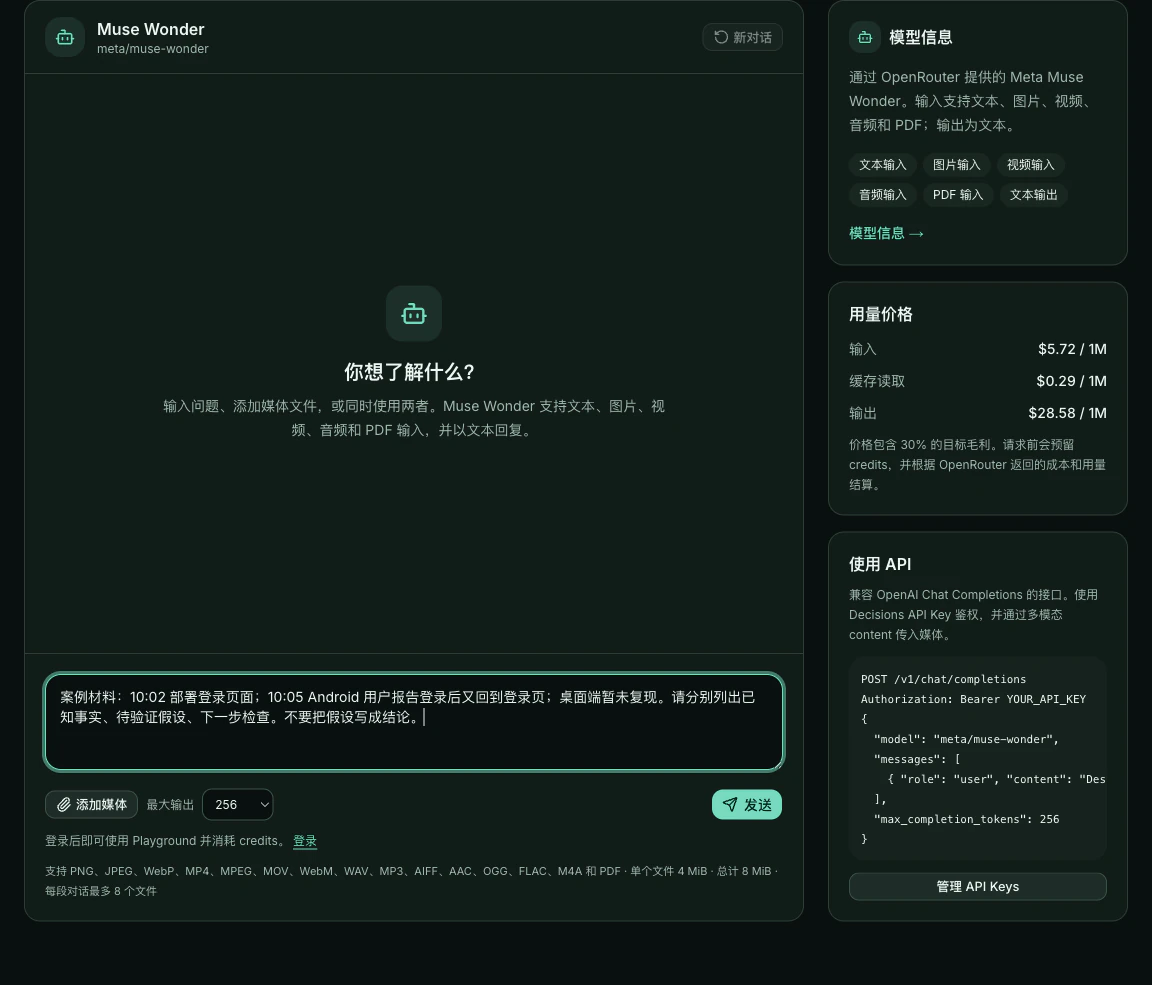
本站当前的该聊天接口提供 meta/muse-wonder,Opus 5.5 需要使用另外的服务入口。本站展示的 Wonder 费率为输入 $5.72、缓存读取 $0.29、输出 $28.58 / 百万 tokens,与前面的上游基础价格口径不同。
此外,这个 Playground 提供文本与媒体对话,当前中转没有启用工具执行或可调推理努力参数。因此,这一步适合检查材料理解和回答质量;要复现 max 设置的代理基准,需要选择支持相应配置和工具的入口。
七、把选择落实到工作类型
现在可以做一张自己的决策表。
| 你的主要任务 | 建议先做什么 |
|---|---|
| 通用编码、知识分析 | 先用 Opus 5.5 建立质量与费用基线 |
| 较长的软件工程任务 | 把 Wonder 加入同仓库、同验收标准的评估 |
| 原生视频、音频理解 | 先确认 Wonder 的入口支持,再与 Opus 的预处理流程比较 |
| 可以等待的离线任务 | 将 Opus Batch 作为单独模式计算 |
| 已有稳定生产流程 | 先小规模验证,再决定是否更换或按任务分流 |
一次模型选择,应当得到一份能复查的记录:它读了什么、做对了什么、用了多久,以及为了交付最终结果总共花了多少。排行榜适合缩小候选范围,这份记录才适合指导产品上线。
延伸阅读
本次选题也参考了 MyClaw 的比较文章 和 Gabriel Anhaia 对 Meta 成绩表的分析。正文中的价格和分数已回到相应官方资料或评测机构核对;这两篇适合继续阅读不同的选型观点。
(完)